넥스젠(NexGen)의 공간 데이터 편집 기능

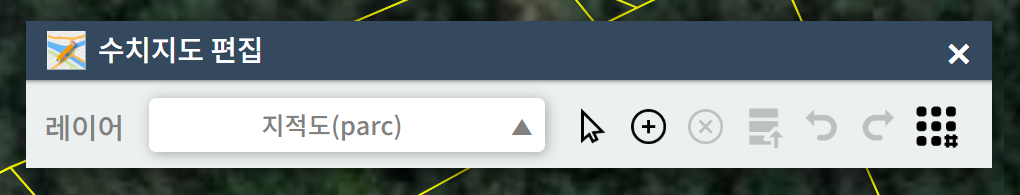
NexGen은 서비스 되는 모든 수치지도 레이어를 편집할 수 있는 범용 기능을 제공합니다. 또한 서비스 되는 모든 수치지도는 NexGen에서 바로 SHP 파일로 다운로드 받을 수 있습니다. 또한 편집에 대한 편의 기능으로 편집 이력의 Undo/Redo와 정점 및 선분에 대한 스냅핑 기능을 제공합니다. 아래는 메인 편집 UI입니다.

보시는 것처럼 편집 대상이 되는 레이어를 선택할 수 있고, 편집하고자 하는 도형을 선택하여 편집하거나 신규 도형을 추가할 수 있으며, 기존의 도형을 삭제할 수 있는 버튼과 함께 Undo/Redo 기능 등이 보입니다.

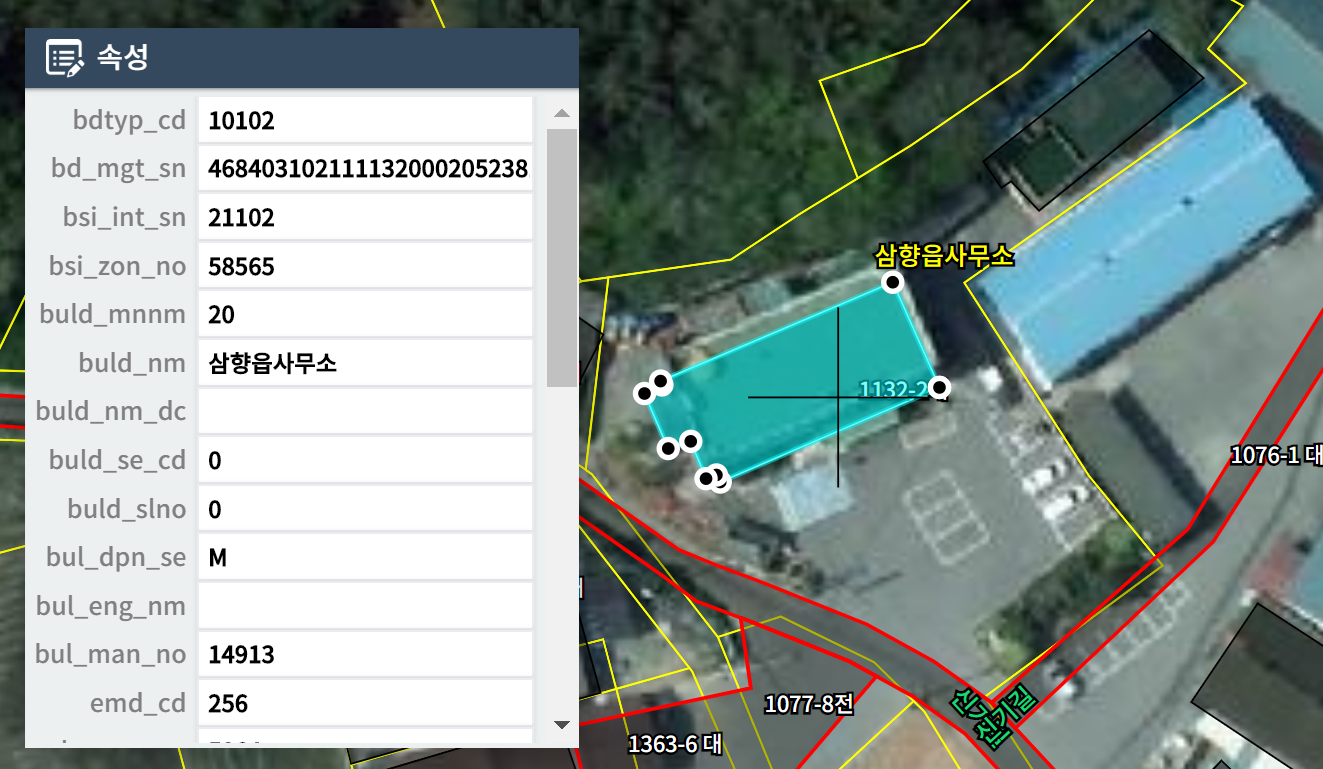
편집 대상이 되는 도형을 선택하거나 새롭게 생성하면 해당 도형에 대한 속성을 편집할 수 있는 창이 아래처럼 표시됩니다. 모든 수치지도 레이에 대한 범용 편집 기능이므로 필드명과 필드값으로 표시됩니다.

위의 UI를 통해 도형 편집 뿐만 아니라 연관된 속성 데이터도 편집할 수 있습니다. 이러한 편집 기능은 범용적인 목적으로 사용되는 편집으로, 특정 목적을 가지는 수치지도에 대한 편집에 대해 다양한 제약조건(코드값 입력 등)은 별도의 커스터마이징으로 추가가 가능합니다.

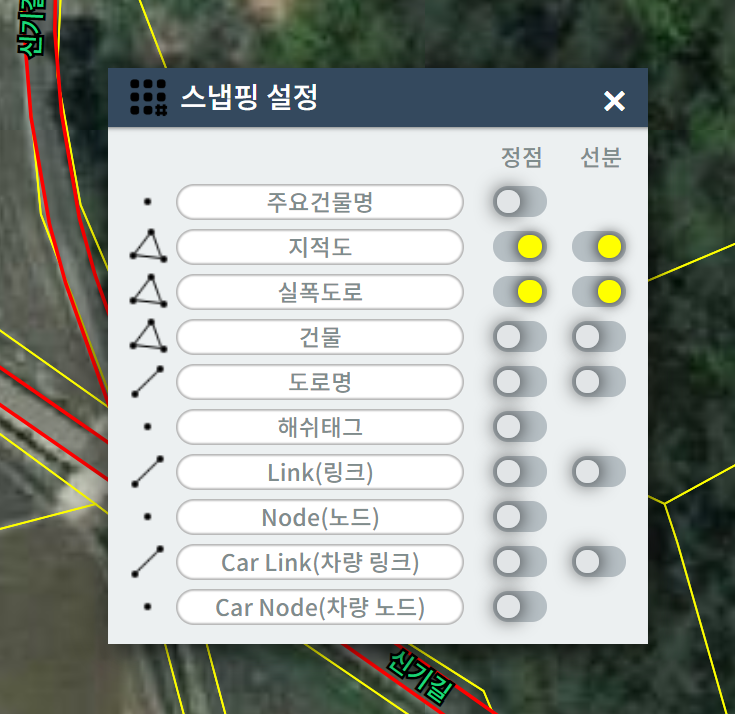
편집에 대한 편의 기능으로써 정점과 선분에 대한 스냅핑 기능을 제공하는데요. 아래의 직관적인 UI를 통해 원하는 레이어에 대해서 정점과 선분을 개별적으로 선택해 스냅핑을 적용할 수 있습니다.

아래는 이러한 편집 기능에 대한 소개 동영상입니다. 건물, 도로, 지적도, POI에 대한 편집을 NexGen의 수치지도 범용 편집기능을 통해 편집하는 내용을 담고 있습니다.

넥스젠(NexGen)의 스타쿼리(* Query) 기능

스타쿼리는 와일드 카드 문자 중에서 모든 것을 의미하는 스타(*) 문자의 의미대로 위치기반 데이터 중 사용자가 검색하고자 하는 모든 것(*)을 하나의 기능만으로 쉽고 빠르며 정확하게 검색할 수 있는 기능입니다.

스타쿼리를 이용하여 행정구역명, 도로명, 지번주소, 도로명주소, 건물명을 기본적으로 검색할 수 있습니다. 또 여기에 사용자가 검색하고자 하는 특화된 데이터를 추가하여 검색할 수 있도록 커스터마이징이 가능합니다.

스타쿼리의 사용자 인터페이스(UI)는 아래처럼 매우 심플합니다.

검색 대상의 종류마다 상이한 UI가 아닌 공통된 하나의 UI만을 제공함으로써 사용자는 부차적인 기능을 학습할 필요없이 원하는 것을 바로 얻을 수 있습니다.

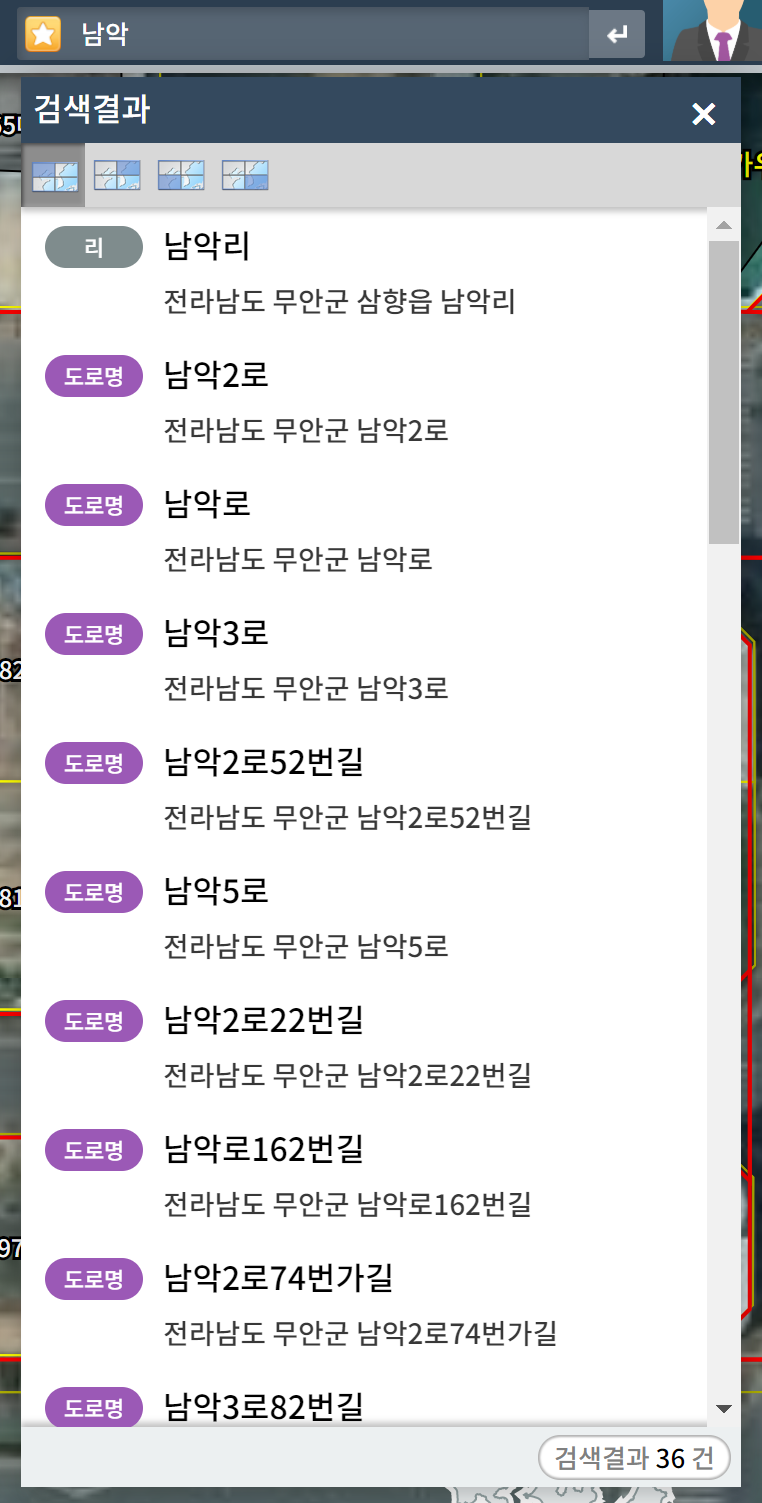
이 UI에 사용자가 검색하고자 하는 키워드를 입력하고 엔터 또는 검색 버튼을 클릭하기만 하면 연관된 결과가 검색창에 표시됩니다. 아래처럼요~!

검색 결과 중 하나를 선택하면 선택된 항목의 위치로 지도가 빠르게 이동합니다. 검색 결과는 물론 지도의 이동까지 너무 빠르죠~! 넥스젠은 사용자가 어떤 결과를 얻기 위해 기다리는 상황이 생기지 않습니다~!

아래는 스타쿼리에 대한 기능을 동영상으로 소개하고 있습니다.

위의 기능 소개에 대한 동영상을 보시면, 도로명 주소와 지번 주소에 대한 위치 검색은 지오코딩(Geocoding) 서비스를 활용합니다. 이 지오코딩 서비스 역시 NexGen의 한 기능이며, 완전한 표준주소가 아닌 불완전한 주소의 경우에도 주소정제(Address Cleaning)을 통해 위치 검색이 가능합니다.

Python과 OpenCV – 54 : 이미지 복원(Image Inpainting)

이 글의 원문은 https://opencv-python-tutroals.readthedocs.io/en/latest/py_tutorials/py_photo/py_inpainting/py_inpainting.html 입니다.

이 글에서는 오래된 사진의 작은 흡집 등을 제거하는 방법인 Inpainting에 대해 살펴보고, 이를 OpenCV의 예제를 통해 살펴 보겠습니다.

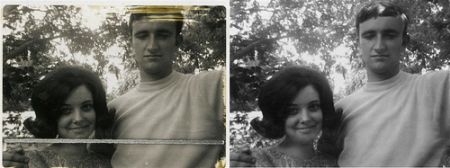
아래의 이미지의 왼쪽처럼 오래된 훼손된 사진에는 작은 흠집이 있는데, 이 흠집을 제거하고 원래의 사진으로 복구할 수 없을까요? 단순하게 이 흠짐을 사진에서 지우는 것만으로는 충분하지 않습니다. 이런 경우 Image Inpainting이라는 기술을 사용할 수 있습니다. 기본 아이디어는 단순합니다. 흠집에 위치한 픽셀을 그 이웃 픽셀을 가져와 교체하는 것입니다.

이런 목적을 위해 설계된 여러가지 알고리즘이 있으며, OpenCV에서는 2가지를 제공합니다. 이 2가지 모두 cv2.inpaint() 함수를 통해 활용할 수 있습니다.

첫번째 알고리즘은 2004년 Alexandru Telea의 논문 “An Image Inpainting Technique Based on the Fast Marching Method”에 기반합니다. 이 알고리즘은 Fast Marching Method에 기반합니다. 복원(Inpainting)하고자 하는 영역에 대해 생각해 봅시다. 이 알고리즘은 먼저 이 영역의 경계로부터 시작하며 영역 내부를 영역의 외곽선부터 시작해 점진적으로 채웁니다. 복원될 곳의 픽셀 주위의 이웃(인근)에 작은 범위의 픽셀을 구합니다. 구해진 픽셀들의 정규화된 가중치 합으로 계산되어진 값으로 복원될 픽셀이 교체됩니다. 가중치 값의 선택은 매우 중요한 문제입니다. 복원 지점에 가깝게 놓여져 있을수록 더 많은 가중치값이 주어집니다. 일단 하나의 픽셀이 복원되면, Fast Matching Method를 사용해 가장 가까운 다음 픽셀로 이동합니다. 이 알고리즘은 cv2.INPAINT_TELEA 플래그를 사용해 활성화됩니다.

두번째 알고리즘은 2001년의 논문인 “Navier-Stokes, Fluid Dynamics, and Image and Video Inpainting”에 기반합니다. 이 알고리즘은 부분 편차 방정식과 유체역학에 기반합니다. 기반 이론은 휴리스틱 방식이며 cv2.INPAINT_NS 플래그를 활성화하여 이 알고리즘을 사용합니다.

이제 2가지의 알고리즘을 OpenCV의 함수를 통해 살펴보겠습니다. 먼저 복원하고자 하는 영역에 해당하는 픽셀에 0이 아닌 값을 담고 있는 마스크 이미지가 필요한데, 이 이미지는 입력 이미지와 크기가 동일해야 합니다. 먼저 cv2.INPAINT_TELEA 프래그에 대한 예제입니다.

import numpy as np
import cv2

img = cv2.imread('./data/inpainting_input.png')
mask = cv2.imread('./data/inpainting_mask.png',0)

dst = cv2.inpaint(img,mask,3,cv2.INPAINT_TELEA)

cv2.imshow('dst',dst)
cv2.waitKey(0)
cv2.destroyAllWindows()

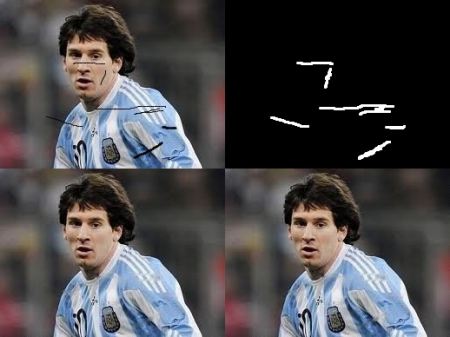
cv2.INPAINT_NS에 대한 알고리즘은 7번 코드의 함수의 인자를 변경하기만 하면 됩니다. 아래의 이미지는 복원되어질 이미지와 마스크 이미지 그리고 2가지 알고리즘에 수행 결과를 모두 표시한 것입니다.

4개의 이미지 중 좌하단의 이미지는 cv2.INPAINT_TELEA에 대한 결과이며, 우하단의 이미지는 cv2.INPAINT_NS의 결과 입니다.

위치 데이터 활용을 위한 웹 GIS 솔루션, 넥스젠(NexGen)의 다양한 배경지도 지원

GIS 기반 솔루션, 넥스젠은 기본적인 GIS 기능을 이미 갖추고 있는 웹 기반 GIS 시스템으로써, 사용자가 보유하고 있는 위치 데이터를 올려 조회 및 관리할 수 있는 제품입니다.

위치 데이터를 효과적으로 활용할 수 있도록 다양한 배경 지도를 제공하는데, 국가 공개 DB를 통한 수치지도나 항공영상을 활용할 수 있고 이미 만들어져 인터넷 환경에서 바로 활용할 수 있는 VWorld의 지형도와 항공영상을 사용할 수 있습니다. 또한 네이버와 카카오 지도도 활용할 수 있습니다. 특히 인터넷이 되지 않는 환경에서, 자체적인 배경지도를 제작하여 활용할 수도 있습니다. (※주의, 저작권을 가진 지도(네이버 또는 카카오 지도 등)를 사용할 경우 해당 제조사와 협의를 통해 지도를 활용하셔야 합니다)

아래는 넥스젠에서 다양한 배경지도를 사용하고 있는 동영상입니다. 자체적으로 제작한 항공영상 기반의 배경지도와 VWorld, 네이버, 카카오 지도가 활용되고 있습니다.

UI는 심플하지만 확장성이 높고, 사용하기 편리하며 직관적입니다. 고객이 원하는 기능과 데이터를 빠르게 추가할 수 있습니다. 활용하고자 하는 위치 데이터를 보유하고 계신다면, 넥스젠을 활용해 보시기 바랍니다. 기본적인 GIS의 기능을 제공하고 있다고 말씀드렸지만, 기본 그 이상의 기능을 제공하고 있습니다. 놀라실 겁니다!

Python과 OpenCV – 48 : kNN을 이용한 글자 인식(OCR)

이 글의 원문은 https://opencv-python-tutroals.readthedocs.io/en/latest/py_tutorials/py_ml/py_knn/py_knn_opencv/py_knn_opencv.html 입니다.

이 글은 손으로 그린 글자를 판독하는 기능에 대한 것입니다. 이를 위해 몇가지 훈련 데이터(train_data)와 시험 데이터(test_data)가 필요합니다. 아래와 같은 2000×1000 픽셀 크기의 digits.png 파일을 사용합니다.
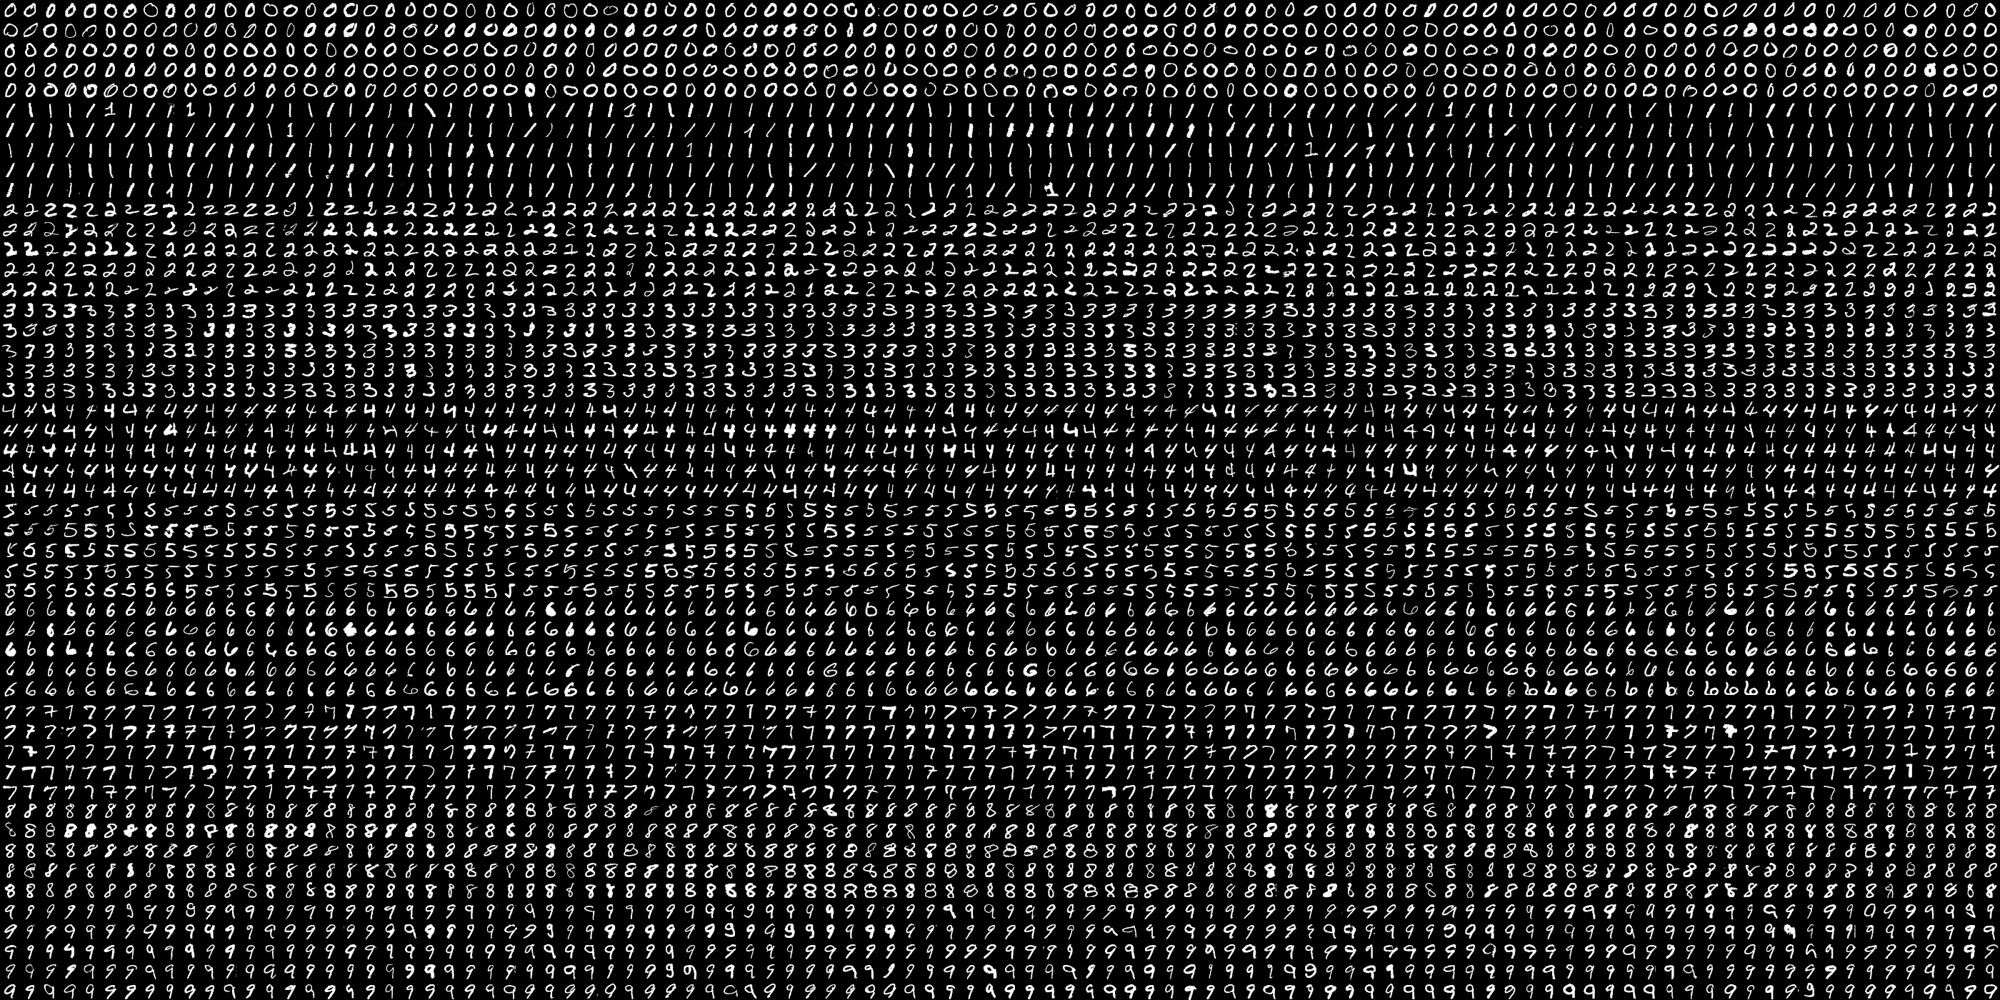
이 이미지에는 손으로 작성한 5000개의 0~9까지의 문자가 담겨 있습니다. 문자 하나당 500개씩 기록되어 있으며, 가로와 세로로 각각 100개씩, 5개씩 표기되어 있습니다. 이미지에서 문자 하나가 차지하는 크기는 20×20 픽셀입니다. 가장 먼저 이 이미지에서 5000개의 문자 단위로 잘라내야 합니다. 그리고 이 20×20 픽셀 크기 문자 이미지를 400 크기의 단일 행으로 만듭니다. 이 데이터가 모든 픽셀에 대한 화소값을 가지는 피쳐셋(Feature Set)입니다. 우리가 생성할 수 있는 가장 단순한 피쳐셋입니다. 이 데이터에서 각 문자의 250개에 해당하는 부분은 train_data로 사용하고 나머지 250개는 test_data로 사용합니다.

이제 코드를 작성해 보면..

import numpy as np
import cv2

img = cv2.imread('./data/digits.png')
gray = cv2.cvtColor(img,cv2.COLOR_BGR2GRAY)

# Now we split the image to 5000 cells, each 20x20 size
cells = [np.hsplit(row,100) for row in np.vsplit(gray,50)]

# Make it into a Numpy array. It size will be (50,100,20,20)
x = np.array(cells)

# Now we prepare train_data and test_data.
train = x[:,:50].reshape(-1,400).astype(np.float32) # Size = (2500,400)
test = x[:,50:100].reshape(-1,400).astype(np.float32) # Size = (2500,400)

# Create labels for train and test data
k = np.arange(10)
train_labels = np.repeat(k,250)[:,np.newaxis]
test_labels = train_labels.copy()

# Initiate kNN, train the data, then test it with test data for k=1
knn = cv2.ml.KNearest_create()
knn.train(train, cv2.ml.ROW_SAMPLE, train_labels)
ret, result, neighbors, dist = knn.findNearest(test, k=5)

# Now we check the accuracy of classification
# For that, compare the result with test_labels and check which are wrong
matches = result==test_labels
correct = np.count_nonzero(matches)
accuracy = correct*100.0/result.size
print(accuracy)

코드를 설명하면, 8번은 digits.png 이미지를 가로로 100개, 세로로 50로 잘라 조각내어 cells 변수에 저장하는데, 각각의 조각 이미지에는 문자 하나가 담겨 있습니다. 11번 코드는 다시 이 cells를 NumPy의 배열로 만들어 x 변수에 저장합니다. 14번 코드는 배열 x 중 절반을 학습 데이터로 사용하고 나머지 절반을 테스트 데이터로 사용하고자 각각 train과 test 변수에 담습니다. train 변수에 저장된 문자에 대해 0~9까지의 값으로 라벨링해줘야 하는데, 18-19번 코드가 그에 해당합니다. 바로 이 train 데이터와 train_labels 데이터가 학습 데이터라고 할 수 있습니다. 이렇게 학습된 데이터를 토대로 test 변수에 저장된 문자들이 0~9까지 중 무엇에 해당하는지 kNN 알고리즘으로 파악하는 것이 23~25번 코드입니다. 최종적으로 테스트 데이터가 정확히 인식되었는지 확인하는 코드가 29~32번 코드입니다. 출력값은 91.76인데, 즉 성공률이 91.76%라는 의미입니다.

인식 정확도를 개선하기 위해서는 인식이 실패한 데이터를 학습시켜 train 변수에 추가하고 다음에 이 변수를 재활용하는 것입니다. 이를 위해 파일에 저장하고 다음에 저장된 파일로부터 불러오는 함수가 필요합니다. 학습 데이터를 저장하는 예는 다음과 같습니다.

np.savez('knn_data.npz',train=train, train_labels=train_labels)

데이터 파일을 불러오는 예는 다음과 같습니다.

with np.load('knn_data.npz') as data:
    print data.files
    train = data['train']
    train_labels = data['train_labels']