전이 학습(Transfer Learning)

전이 학습(Transfer Learning)은 특정 분야에서 학습된 신경망의 일부 능력을 유사하거나 전혀 새로운 분야에서 사용되는 신경망의 학습에 이용하는 것을 의미합니다.

이미지 분류를 예로 들어 Resnet이나 VGG 등과 같은 신경망의 구성 중 앞단은 CNN 레이어로 구성되어 있습니다. 이 CNN 레이어는 이미지의 특징을 추출하는 능력을 갖는데요. 처음에는 신형성을 추출하고 다음에는 패턴을, 마지막에는 형상 등을 추출한다고 알려져 있습니다. 이러한 이미지의 특징을 추출하는 신경망의 능력은 다른 분야에서도 활용될 수 있습니다. 즉, 수만에서 수천만장의 이미지를 통해 학습된 높은 성능을 갖는 Resnet이나 VGG 신경망의 특징 추출 능력을 그대로 이용하고, 마지막 출력 계층으로써.. 주로 선형(Affine; 가중치와 편향에 대한 행렬 연산) 레이어만을 변경하여 이 변경된 레이어만을 재학습시키는 것이 전이 학습입니다.

전이 학습은 학습 데이터의 수가 적을때도 효과적이며, 학습 속도도 빠릅니다. 그리고 전이학습 없이 학습하는 것보다 훨씬 높은 정확도를 제공한다는 장점이 있습니다.

이 글은 Resnet과 VGG 신경망에 대한 전이학습 코드 중 전이학습을 위한 전처리 코드를 정리합니다. 나머지 학습 등의 코드는 여타 다른 신경망과 동일합니다. 먼저 전이학습을 위한 Resnet 신경망의 전처리 코드입니다.

import torch.nn as nn
from torchvision import models

net = models.resnet18(pretrained=True)

for p in net.parameters():
    p.requires_grad = False

fc_input_dim = net.fc.in_features
net.fc = nn.Linear(fc_input_dim, 2)

먼저 이미 학습된 resnet18 신경망을 불러오고, 이 신경망의 가중치가 학습되지 않도록 합니다. 그리고 이 신경망의 마지막 구성 레이어(fully connected layer로써 Affine Layer, Dense layer라고도 함)의 입력 데이터 수를 얻고, 이렇게 얻는 입력 데이터의 수와 출력하고자 하는, 즉 분류 개수인 2에 대한 선형 레이어를 생성하여 신경망을 구성하는 마지막 레이어를 교체합니다. 결과적으로 이 신경망의 마지막 레이어를 제외한 특징 추출 레이어들은 학습되지 않고, 마지막 레이어만이 학습될 것입니다.

참고로 위의 신경망의 구성 레이어를 출력하는 코드와 그 결과는 다음과 같은데, 구성 레이어의 마지막이 fc라는 것을 알 수 있습니다.

for name,module in net.named_children():
    print(name)

''' output:
conv1
bn1
relu
maxpool
layer1
layer2
layer3
layer4
avgpool
fc
'''

다음은 VGG 신경망에 대한 전이학습 전처리 코드입니다.

from torchvision import models

net = models.vgg16(pretrained=True)
 
features = net.features
for params in vgg.features.parameters():
    param.requires_grad = False

net.classifier[6].out_features = 2

객체 net을 생성한 후 바로 print(net)을 실행해 보면 다음과 같은 출력을 볼 수 있습니다.

VGG(
  (features): Sequential(
    (0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (1): ReLU(inplace=True)
    (2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (3): ReLU(inplace=True)
    (4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
    (5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (6): ReLU(inplace=True)
    (7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (8): ReLU(inplace=True)
    (9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
    (10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (11): ReLU(inplace=True)
    (12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (13): ReLU(inplace=True)
    (14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (15): ReLU(inplace=True)
    (16): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
    (17): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (18): ReLU(inplace=True)
    (19): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (20): ReLU(inplace=True)
    (21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (22): ReLU(inplace=True)
    (23): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
    (24): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (25): ReLU(inplace=True)
    (26): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (27): ReLU(inplace=True)
    (28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (29): ReLU(inplace=True)
    (30): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (avgpool): AdaptiveAvgPool2d(output_size=(7, 7))
  (classifier): Sequential(
    (0): Linear(in_features=25088, out_features=4096, bias=True)
    (1): ReLU(inplace=True)
    (2): Dropout(p=0.5, inplace=False)
    (3): Linear(in_features=4096, out_features=4096, bias=True)
    (4): ReLU(inplace=True)
    (5): Dropout(p=0.5, inplace=False)
    (6): Linear(in_features=4096, out_features=1000, bias=True)
  )
)

(classifier)의 마지막 구성요소[6]을 보면 out_features가 1000으로 되어 있는 것을 볼 수 있고, 이를 분류하고자 하는 개수인 2로 변경하는 전처리 코드였습니다.

Python에서 tqdm 라이브러리를 이용한 작업진행률 표시

다음과 같은 코드가 있다고 하자.

from time import sleep

for i in range(1, 600):
    sleep(0.1) # 무언가 시간이 많이 소요되는 연산군

for 문 안에 시간이 많이 소요되는 코드가 있을 때 얼마만큼 진행되는지에 대한 피드백을 사용자에게 주지 못하면 사용자는 아마도 ^C를 누르거나 ^@Del을 눌러 프로세스를 강제 종료할지도 모른다. 이럴때 사용자에게 피드백을 줄 필요가 있는데 이때 매우 간단하고 효과적으로 진행상황을 피드백으로 제공할 수 있는 tqdm 라이브러리가 있다.

사용은 다음처럼 for 문의 in 구문을 tqdm으로 감싸기만 하면 끝.

from tqdm import tqdm
from time import sleep

for i in tqdm(range(1, 600)):
    sleep(0.1) # 무언가 시간이 많이 소요되는 연산군

그러면 아래처럼 진행상황에 대한 정보가 효과적으로 시각화된다.

위의 진행상태에 대한 정보에서 43%는 진행률, 257/599는 전체 599번 중 현재 257번째 작업 수행중, 00:27<00:36은 전체 작업 완료까지 남은 시간은 36초이며 현재 27초 경과되었다는 것, 9.35it/s는 1초당 평균 9.35번의 반복을 수행했다는 것에 대한 정보다. 참고로 tqdm은 아랍어로 Progress라는 의미(taqadum, تقدّم)라고 한다.

[텐서플로2] MNIST 데이터를 훈련 데이터로 사용한 DNN 학습

TensorFlow 2에서 손글씨로 작성해 스캔한 MNIST 데이터를 DNN 모델 학습을 통해 분류하는 코드를 정리해 봅니다.

먼저 아래처럼 텐서플로 라이브러리를 임포트 해야 합니다.

import tensorflow as tf

텐서플로와 케라스가 매우 밀접하게 통합되었고, 다양한 데이터셋이 케라스 라이브러리를 통해 활용할 수 있습니다. 아래의 코드를 통해 MNIST 데이터셋을 인터넷을 통해 가져옵니다.

(x_train, y_train), (x_test, y_test) = tf.keras.datasets.mnist.load_data()
x_train, x_test = x_train / 255.0, x_test / 255.0

x_train에는 총 60000개의 28×28 크기의 이미지가 담겨 있으며, y_train에는 이 x_train의 60000개에 대한 값(0~9)이 담겨 있는 레이블 데이터셋입니다. 그리고 x_train과 y_train은 각각 10000개의 이미지와 레이블 데이터셋입니다. 먼저 x_train와 y_train을 통해 모델을 학습하고 난 뒤에, x_test, y_test 를 이용해 학습된 모델의 정확도를 평가하게 됩니다. 다음 코드는 신경망 모델입니다.

model = tf.keras.models.Sequential([
    tf.keras.layers.Flatten(input_shape=(28, 28)),
    tf.keras.layers.Dense(128, activation='relu'),
    tf.keras.layers.Dropout(0.2),
    tf.keras.layers.Dense(10, activation='softmax')
])

총 4개의 레이어로 구성된 신경망인데, 1번째 레이어는 입력 이미지의 크기가 28×28이므로 이를 1차원 텐서로 펼치는 것이고, 2번째 레이어는 1번째 레이어에서 제공되는 784 개의 값(28×28)을 입력받아 128개의 값으로 인코딩해 주는데, 활성함수로 ReLU를 사용하도록 하였습니다. 2번째 레이어의 실제 연산은 1번째 레이어에서 제공받은 784개의 값을 784×128 행렬과 곱하고 편향값을 더하여 얻은 128개의 출력값을 다시 ReLU 함수에 입력해 얻은 128개의 출력입니다. 3번째는 128개의 뉴런 중 무작위로 0.2가 의미하는 20%를 다음 레이어의 입력에서 무시합니다. 이렇게 20% 정도가 무시된 값이 4번째 레이어에 입력되어 충 10개의 값을 출력하는데, 여기서 사용되는 활성화 함수는 Softmax가 사용되었습니다. Softmax는 마지막 레이어의 결과값을 다중분류를 위한 확률값으로 해석할 수 있도록 하기 위함입니다. 10개의 값을 출력하는 이유는 입력 이미지가 0~9까지의 어떤 숫자를 의미하는지에 대한 각각의 확률을 얻고자 함입니다. 이렇게 정의된 모델을 학습하기에 앞서 다음처럼 컴파일합니다.

model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

모델의 학습 중에 역전파를 통한 가중치 최적화를 위한 기울기 방향에 대한 경사하강을 위한 방법으로 Adam을 사용했으며 손실함수로 다중 분류의 Cross Entropy Error인 ‘sparse_categorical_crossentropy’를 지정하였습니다. 그리고 모델 평가를 위한 평가 지표로 ‘accuracy’를 지정하였습니다. 이제 다음처럼 모델을 학습할 수 있습니다.

model.fit(x_train, y_train, epochs=5)

학습에 사용되는 데이터넷과 학습 반복수로 5 Epoch을 지정했습니다. Epoch은 전체 데이터셋에 대해서 한번 학습할때의 단위입니다. 학습이 완료되면 다음과 같은 내용이 출력됩니다.

Train on 60000 samples
Epoch 1/5
2019-11-16 21:24:27.115767: I tensorflow/stream_executor/platform/default/dso_loader.cc:44] Successfully opened dynamic library cublas64_100.dll
60000/60000 [==============================] – 6s 103us/sample – loss: 0.2971 – accuracy: 0.9137
Epoch 2/5
60000/60000 [==============================] – 5s 78us/sample – loss: 0.1428 – accuracy: 0.9577
Epoch 3/5
60000/60000 [==============================] – 5s 79us/sample – loss: 0.1074 – accuracy: 0.9676
Epoch 4/5
60000/60000 [==============================] – 5s 80us/sample – loss: 0.0846 – accuracy: 0.9742
Epoch 5/5
60000/60000 [==============================] – 5s 80us/sample – loss: 0.0748 – accuracy: 0.9766

다음 코드로 모델을 평가합니다.

model.evaluate(x_test,  y_test, verbose=2)

평가를 위한 데이터셋을 지정하고, 평가가 끝나면 다음과 같이 평가 데이터셋에 대한 손실값과 정확도가 결과로 표시됩니다.

10000/1 – 1s – loss: 0.0409 – accuracy: 0.9778

이미지 분류 모델의 구성 레이어에 대한 결과값 시각화

이미지에 대한 Classification 및 Detection, Segmentation에 대한 신경망 모델을 구성하는 레이어 중 Convolution 관련 레이어의 결과값에 대한 시각화에 대한 내용입니다. 딥러닝 라이브러리 중 PyTorch로 예제를 작성했으며, CNN 모델 중 가장 이해하기 쉬운 VGG를 대상으로 하였습니다.

먼저 필요한 패키지와 미리 학습된 VGG 모델을 불러와 그 레이어 구성을 출력해 봅니다.

import matplotlib.pyplot as plt
from torchvision import transforms
from torchvision import models
from PIL import Image

vgg = models.vgg16(pretrained=True).cuda()
print(vgg)

결과는 다음과 같습니다.

VGG(
(features): Sequential(
(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(1): ReLU(inplace=True)
(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(3): ReLU(inplace=True)
(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(6): ReLU(inplace=True)
(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(8): ReLU(inplace=True)
(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(11): ReLU(inplace=True)
(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(13): ReLU(inplace=True)
(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(15): ReLU(inplace=True)

.
.

(생략)

위의 특징(Feature)를 추출하는 레이어 중 0번째 레이어의 출력결과를 시각화 합니다. PyTorch는 특정 레이어의 입력 데이터와 그 연산의 결과를 특정 함수로, 연산이 완료되면 전달해 호출해 줍니다. 아래는 이에 대한 클래스입니다.

class LayerResult:
    def __init__(self, payers, layer_index):
        self.hook = payers[layer_index].register_forward_hook(self.hook_fn)
    
    def hook_fn(self, module, input, output):
        self.features = output.cpu().data.numpy()
    
    def unregister_forward_hook(self):
        self.hook.remove()

LayerResult은 레이어의 연산 결과를 검사할 레이어를 특정하는 인자를 생성자의 인자값으로 갖습니다. 해당 레이어의 register_forward_hook 함수를 호출하여 그 결과를 얻어올 함수를 등록합니다. 등록된 함수에서 연산 결과를 시각화하기 위한 데이터 구조로 변환하게 됩니다. 이 클래스를 사용하는 코드는 다음과 같습니다.

result = LayerResult(vgg.features, 0)

img = Image.open('./images/cat.jpg')
img = transforms.ToTensor()(img).unsqueeze(0)
vgg(img.cuda())

activations = result.features

위의 코드의 마지막 라인에서 언급된 activations에 특정 레이어의 결과값이 담겨 있습니다. 이제 이 결과를 출력하는 코드는 다음과 같습니다.

fig, axes = plt.subplots(8,8)
for row in range(8):
    for column in range(8):
        axis = axes[row][column]
        axis.get_xaxis().set_ticks([])
        axis.get_yaxis().set_ticks([])
        axis.imshow(activations[0][row*8+column])

plt.show()

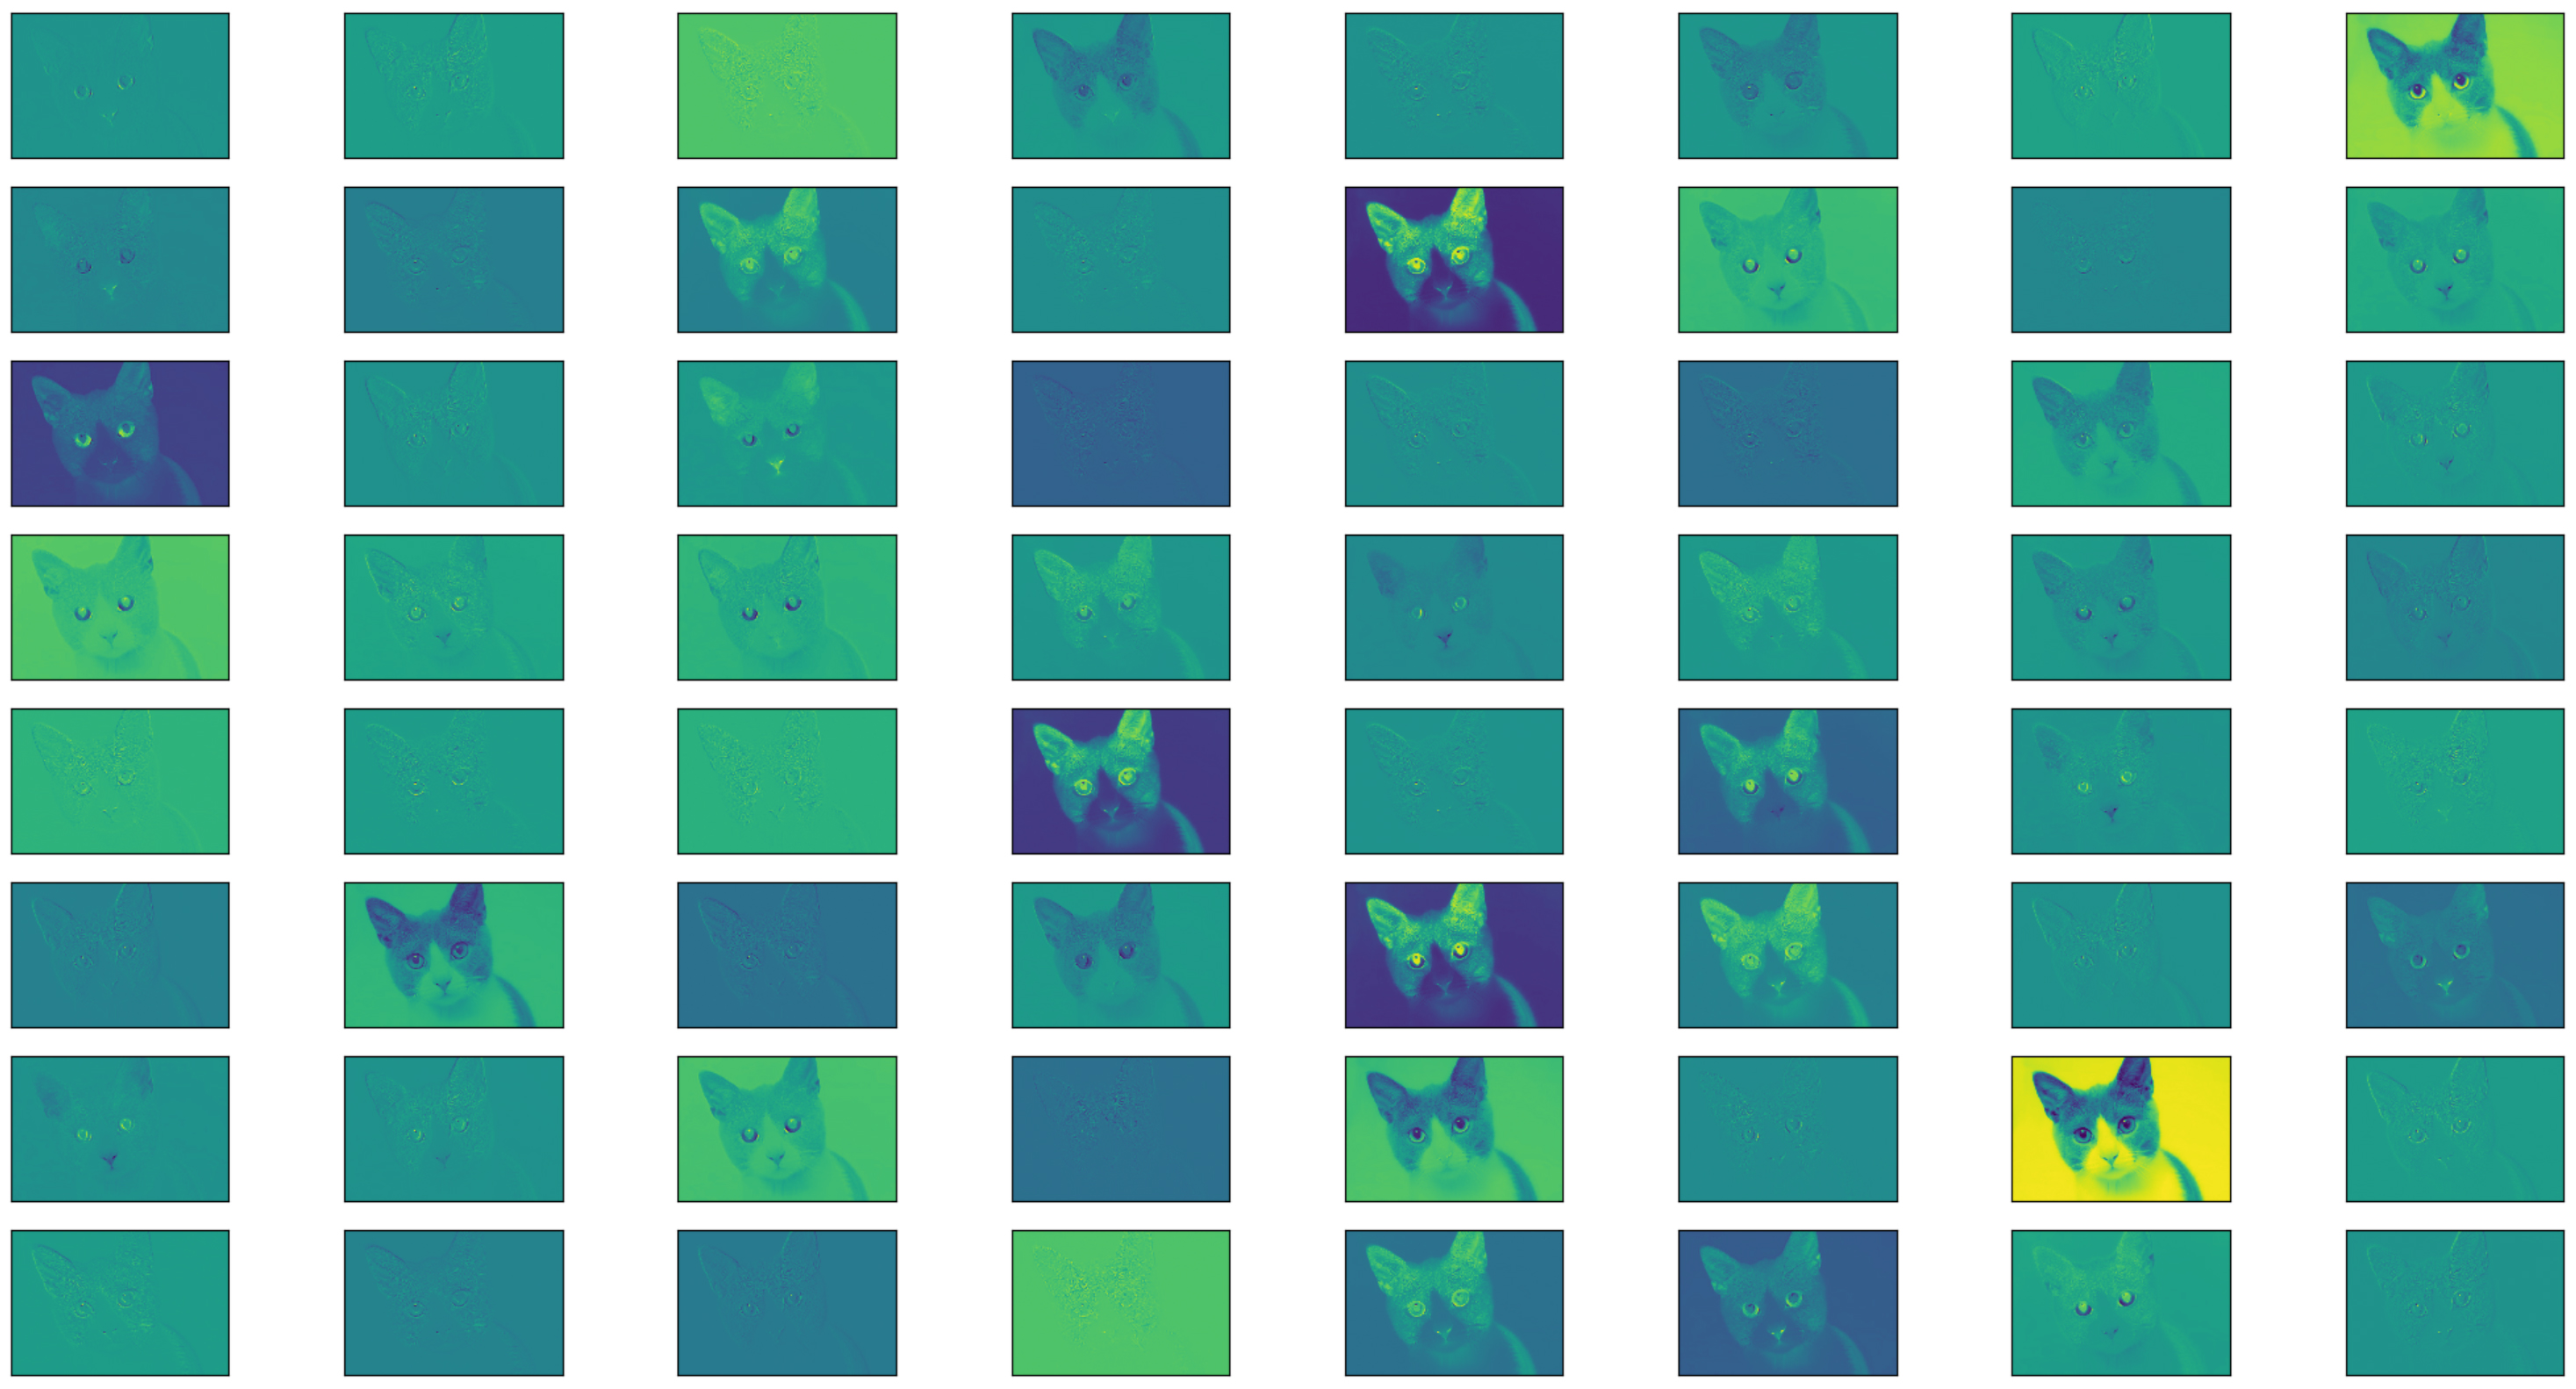
결과 이미지가 총 64인데, 이는 앞서 VGG의 구성 레이어를 살펴보면, 첫번째 레이어의 출력 채널수가 64개이기 때문입니다. 결과는 다음과 같습니다.

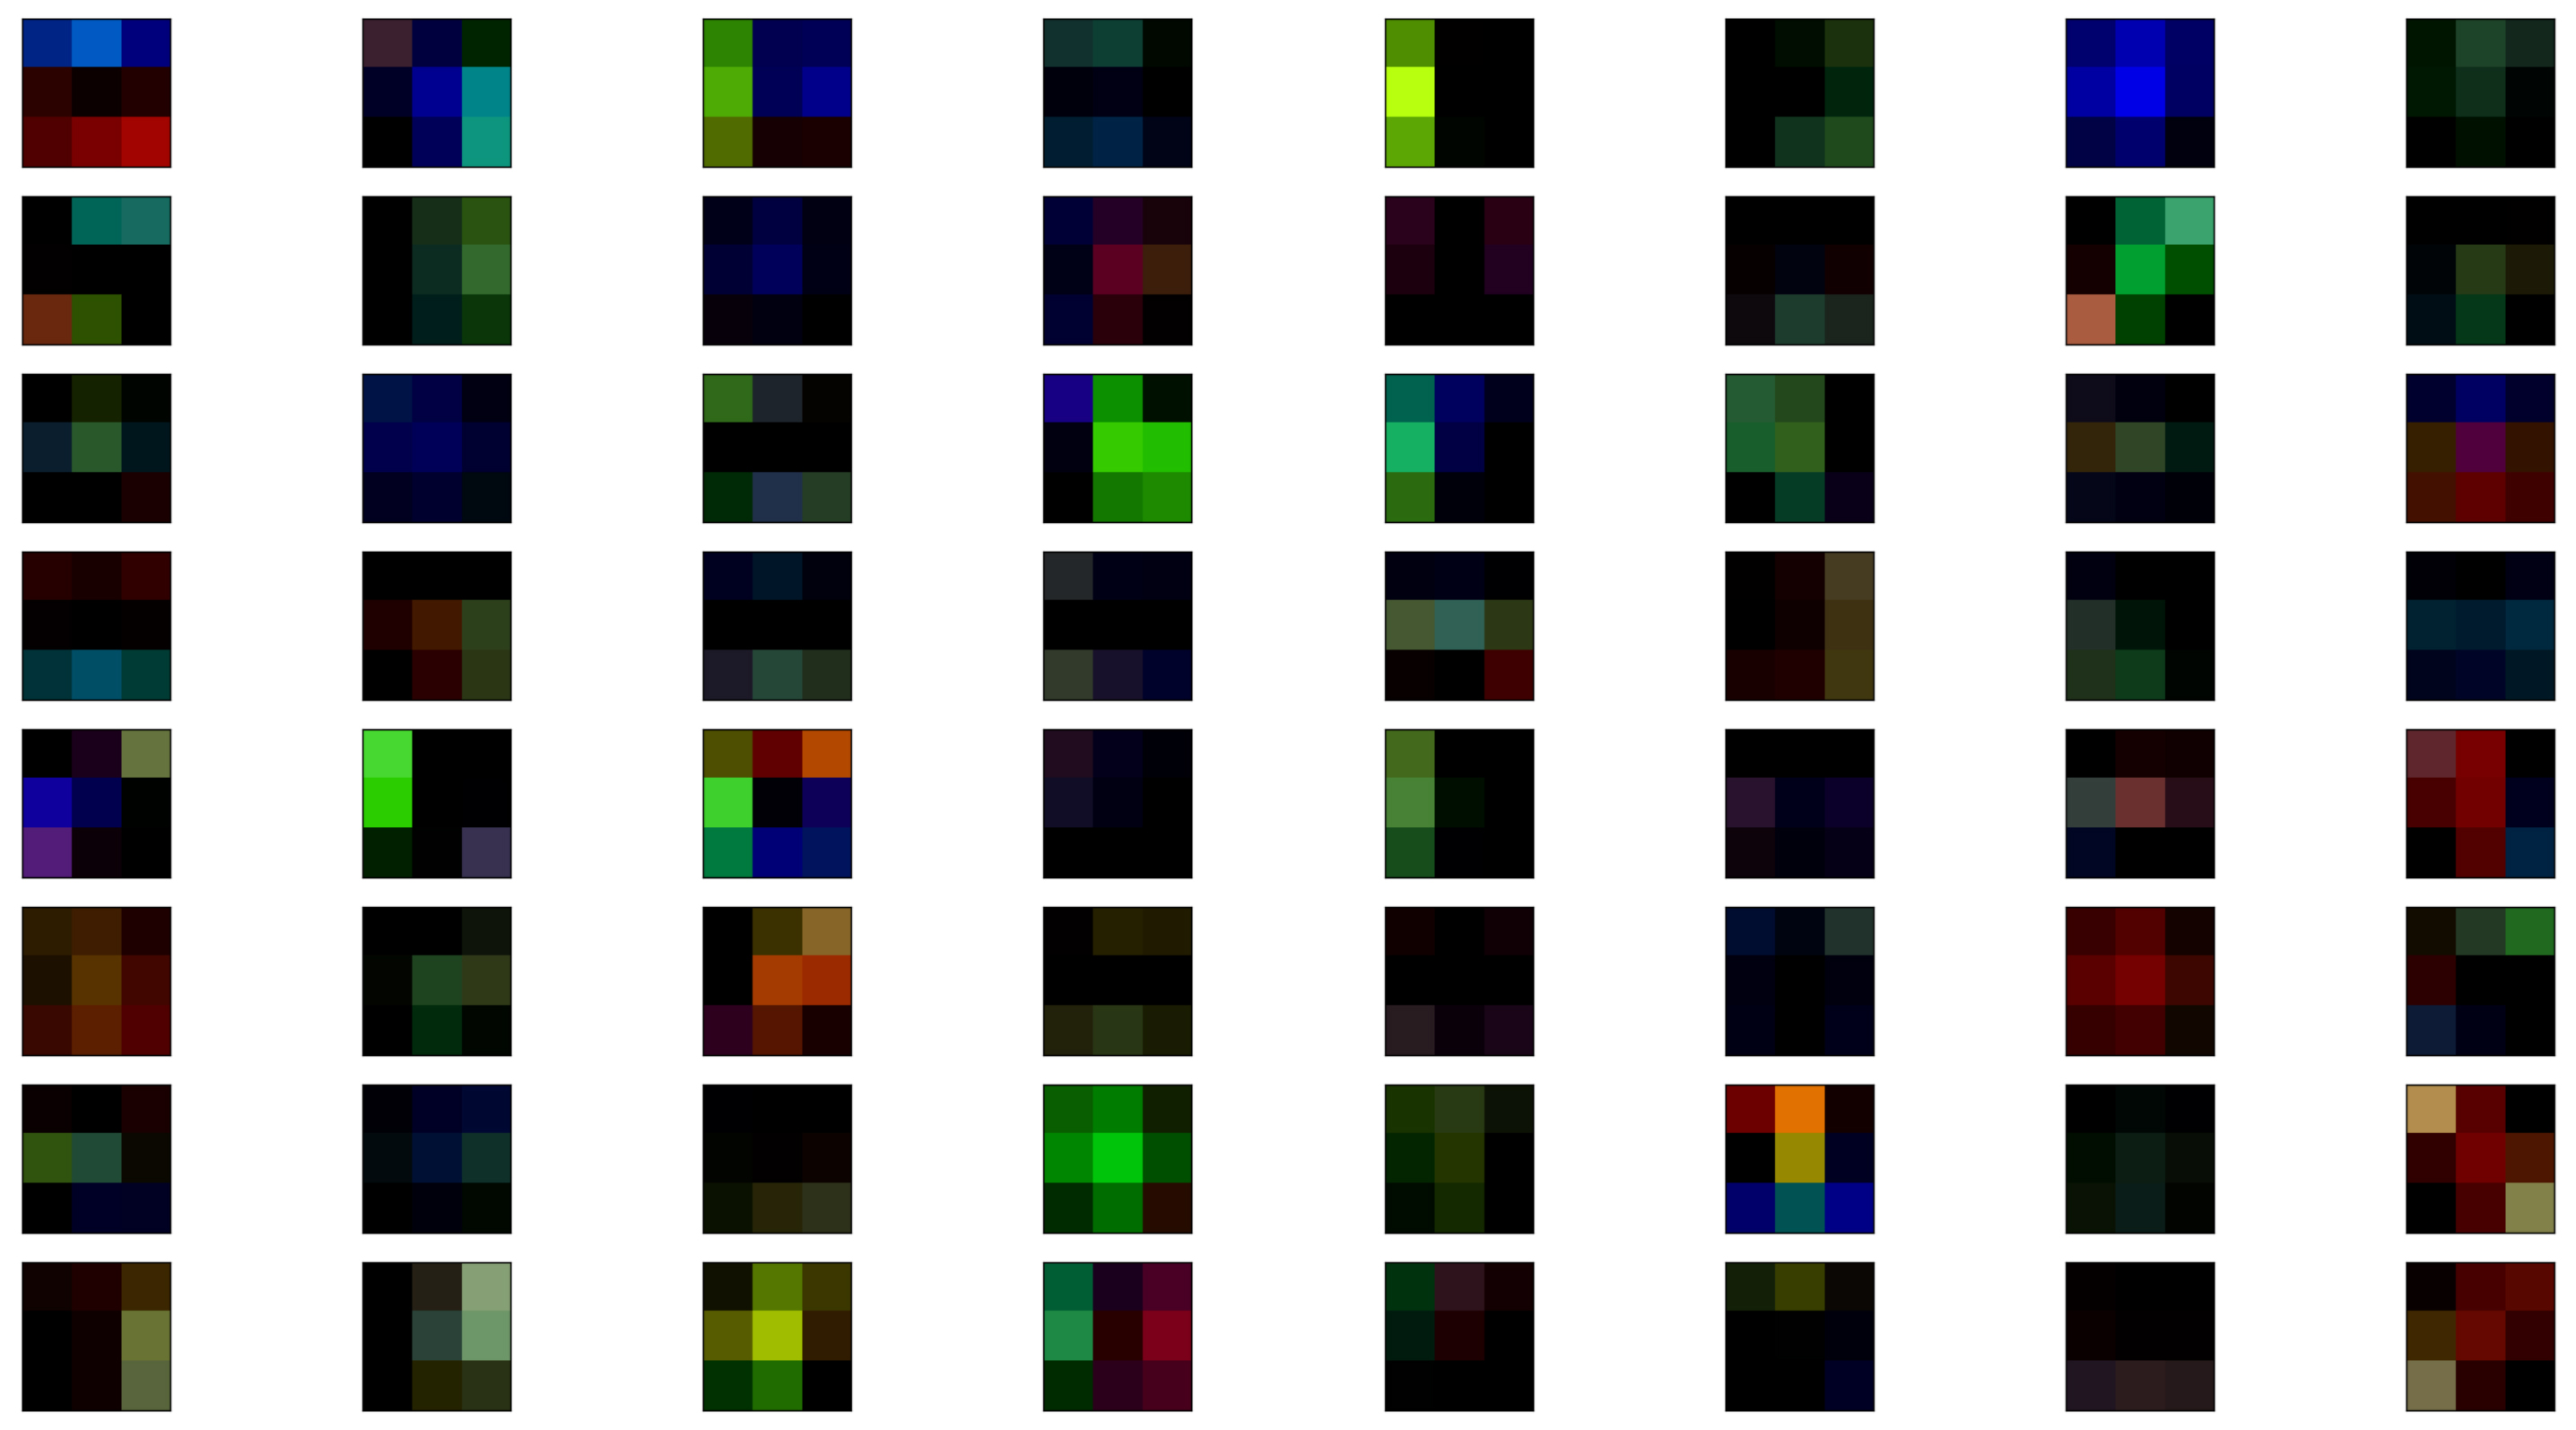
추가로 특정 레이어의 가중치값 역시 시각화가 가능합니다. 아래의 코드가 그 예입니다.

import matplotlib.pyplot as plt
from torchvision import transforms
from torchvision import models
from PIL import Image

vgg = models.vgg16(pretrained=True).cuda()

print(vgg.state_dict().keys())
weights = vgg.state_dict()['features.0.weight'].cpu()

fig, axes = plt.subplots(8,8)
for row in range(8):
    for column in range(8):
        axis = axes[row][column]
        axis.get_xaxis().set_ticks([])
        axis.get_yaxis().set_ticks([])
        axis.imshow(weights[row*8+column])

plt.show()

9번 코드에서 가중치를 가지는 레이어의 ID를 출력해 주는데, 그 결과는 다음과 같습니다.

odict_keys([‘features.0.weight’, ‘features.0.bias’, ‘features.2.weight’, ‘features.2.bias’, ‘features.5.weight’, ‘features.5.bias’, ‘features.7.weight’, ‘features.7.bias’, ‘features.10.weight’, ‘features.10.bias’, ‘features.12.weight’, ‘features.12.bias’, ‘features.14.weight’, ‘features.14.bias’, ‘features.17.weight’, ‘features.17.bias’, ‘features.19.weight’, ‘features.19.bias’, ‘features.21.weight’, ‘features.21.bias’, ‘features.24.weight’, ‘features.24.bias’, ‘features.26.weight’, ‘features.26.bias’, ‘features.28.weight’, ‘features.28.bias’, ‘classifier.0.weight’, ‘classifier.0.bias’, ‘classifier.3.weight’, ‘classifier.3.bias’, ‘classifier.6.weight’, ‘classifier.6.bias’])

위의 레이어 ID로 가중치값을 가져올 레이어를 특정할 수 있는데요. 최종적으로 위의 코드는 다음과 같이 가중치를 시각화해 줍니다.

파이썬의 matplotlib 노트

파이썬의 matplotlib는 수치 데이터를 그래프로 효과적으로 표시해주는 API입니다. 이에 대해 간단한 활용 예시에 대한 코드를 기록해 둡니다.

import matplotlib.pyplot as plt

x = [1, 2, 3, 4, 5]
y = [1, 2, 3, 4, 5]

plt.scatter(x, y)

plt.show()

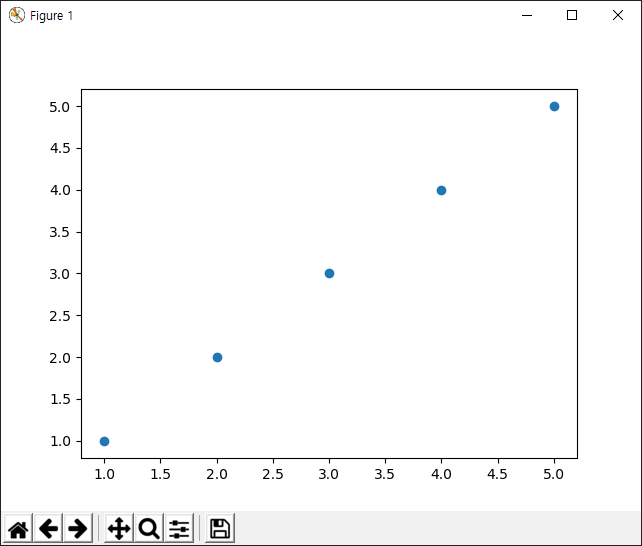
X축과 Y축에 대한 포인트 데이터를 표시하는 코드입니다. 결과는 다음과 같습니다.

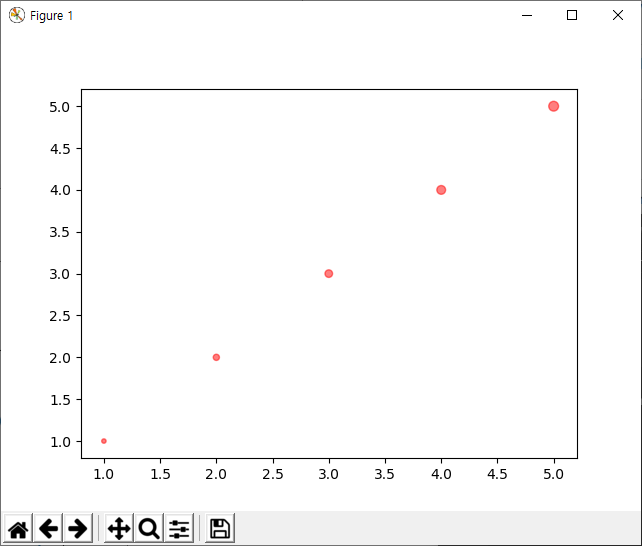
그래프에서 포인트의 크기와 색상, 투명도를 지정하는 예제는 다음과 같습니다.

import matplotlib.pyplot as plt

x = [1, 2, 3, 4, 5]
y = [1, 2, 3, 4, 5]
s = [10, 20, 30, 40, 50]

plt.scatter(x = x, y = y, s = s, c = 'red', alpha=0.5)

plt.show()

결과는 다음과 같습니다.

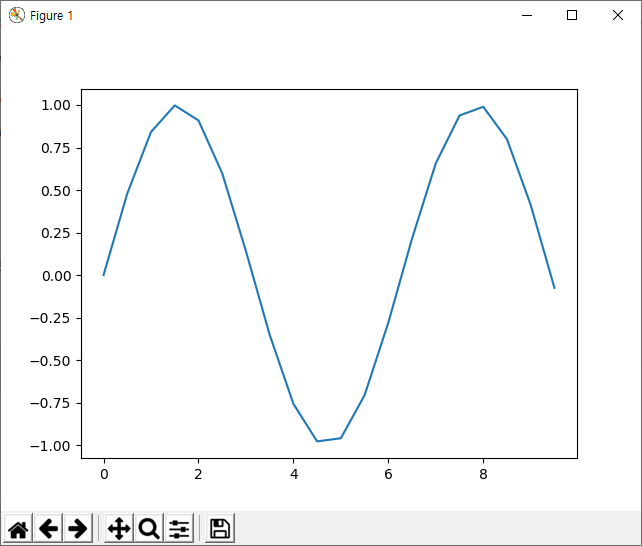
다음은 꺽은선 그래프입니다.

import numpy as np
import matplotlib.pyplot as plt

x = np.arange(0, 10, 0.5)
y = np.sin(x)

plt.plot(x, y)
plt.show()

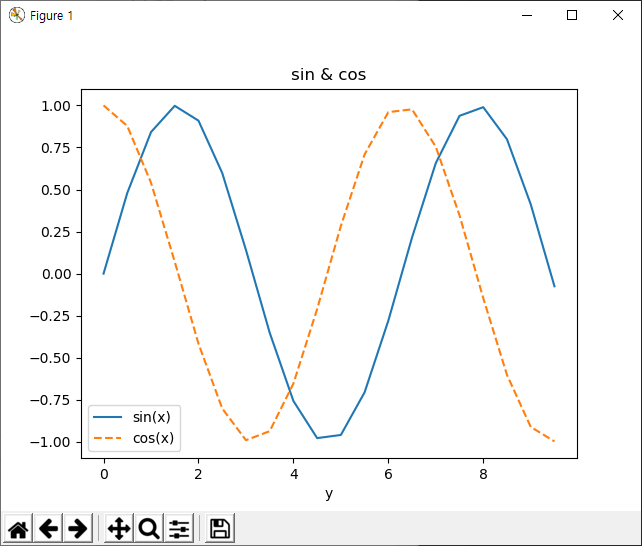
x축과 y축의 데이터는 4번과 5번 코드에서 정의합니다. 결과는 다음과 같습니다.

하나의 차트에 여러개의 그래프를 동시에 표시하고, 추가적으로 제목, 축이름 등을 표시하는 코드입니다.

import numpy as np
import matplotlib.pyplot as plt

x = np.arange(0, 10, 0.5)
y1 = np.sin(x)
y2 = np.cos(x)

plt.plot(x, y1, label="sin(x)")
plt.plot(x, y2, label="cos(x)", linestyle="--")

plt.xlabel("x")
plt.xlabel("y")

plt.title("sin & cos")
plt.legend()

plt.show()

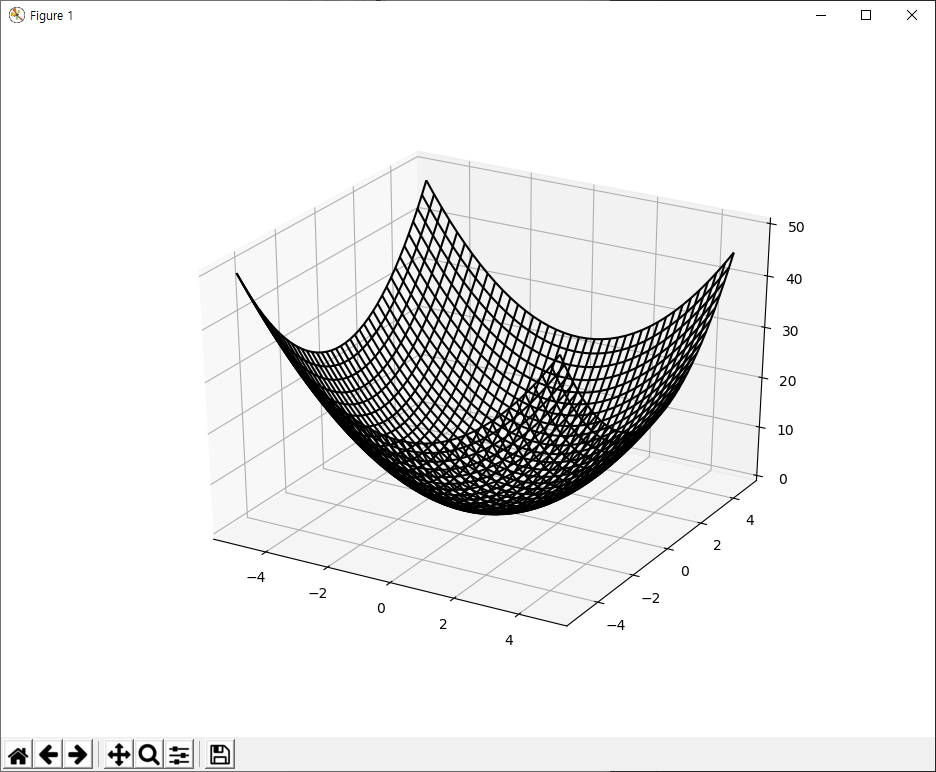
3차원 차트의 경우 먼저 X, Y축에 대한 데이터와 이 X, Y를 변수로 하여 계산된 Z 값의 함수가 정의해야 합니다. 이렇게 정의된 X, Y, Z에 대한 3차원 그래프는 아래의 예제 코드를 통해 3차원 차트로 시각화할 수 있습니다.

import numpy as np
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt

X = np.arange(-5, 5, 0.25)
Y = np.arange(-5, 5, 0.25)
X, Y = np.meshgrid(X, Y)
Z = X**2 + Y**2

fig = plt.figure()
ax = fig.gca(projection='3d')
surf = ax.plot_wireframe(X, Y, Z, color='black')

plt.show()

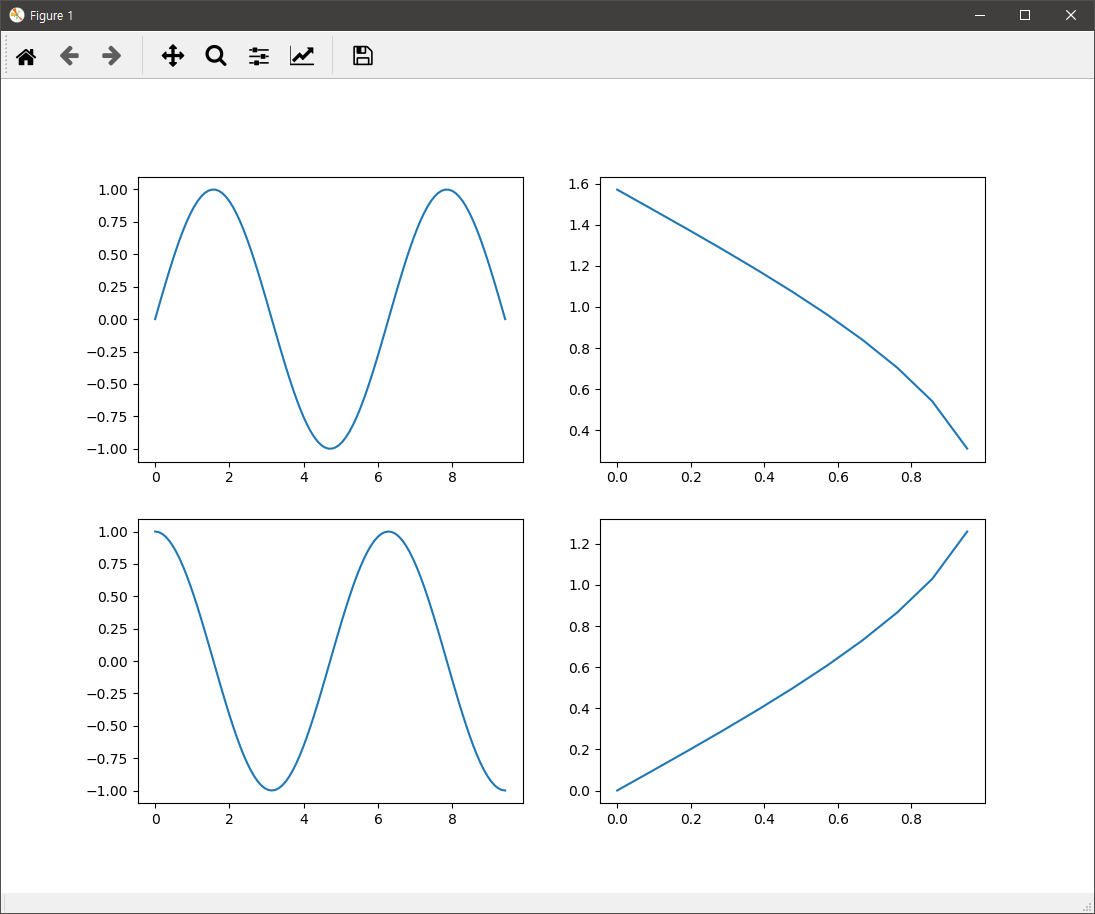
여러개의 차트를 동시에 표시하는 경우입니다.

import matplotlib.pyplot as plt
import numpy as np

x = np.linspace(0, np.pi * 3, 100)
fig, axes = plt.subplots(2,2)

axes[0][0].plot(x, np.sin(x))
axes[0][1].plot(x, np.arccos(x))
axes[1][0].plot(x, np.cos(x))
axes[1][1].plot(x, np.arcsin(x))

plt.show()

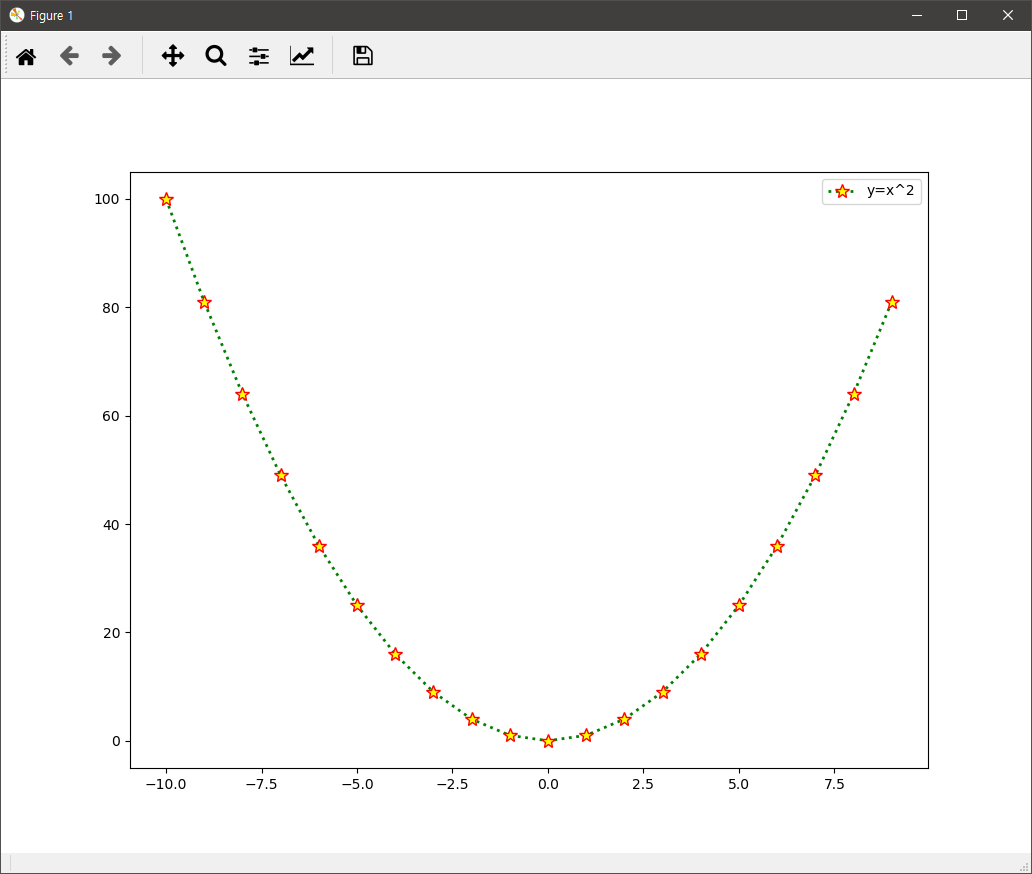
아래는 차트를 그리는 스타일을 지정하고 범례를 표현하는 코드입니다.

import matplotlib.pyplot as plt
import numpy as np

x = np.arange(-10,10)
y = x**2

plt.plot(x, y, 
    linewidth=2, color='green', linestyle=':', 
    marker='*', markersize=10, markerfacecolor='yellow', markeredgecolor='red', 
    label='y=x^2')
   
plt.legend()

plt.show()

결과는 다음과 같습니다.