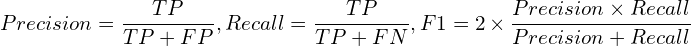
Javascript의 Promise API 요약

Promise는 코드의 실행 흐름에서 비동기처리를 유연하게 처리하기 위한 API입니다. 코드를 통해 살펴보겠습니다.

function test(callback) {
    setTimeout(() => {
        callback();
    }, 2000);
}

function callback() {
    console.log('Hello!')
}

test(callback);

위의 코드는 2초 뒤에 콘솔에 Hello!를 출력합니다. 이 코드를 Promise API로 대체하면 아래와 같습니다.

function test() {
    return new Promise((resolve, reject) => {
        setTimeout(() => {
            resolve(); 
        }, 2000);
    })
}

function callback() {
    console.log('Hello!');
}

test().then(callback);

좀더 완전한 Promise API를 위한 위의 코드에서 확장된 코드를 살펴보면 아래와 같습니다.

function test() {
    return new Promise((resolve, reject) => {
        setTimeout(() => {
            let bOK = true;

            console.log('1');            
            if(bOK) {
                resolve(1); // [Fulfilled State] 1, 2를 콘솔에 출력하고 적당한 시점에 then으로 넘겨준 함수를 호출해 줌           
            } else {
                reject(-1); // [Rejected State] 1, 2를 콘솔에 출력하고 적당한 시점에 예외를 발생시킴
            }
            console.log('2'); 
        }, 2000);
    })
}

function callback(result) {
    console.log('Hello! : ' + result)
}

let p = test(); // [Pending State]
p.then(callback); // Promise의 resolve 호출에 의해 callback이 호출됨

Promise는 3가지 상태를 갖는다고 합니다. Promise 객체가 생성되어 사용될 준비가 된 Pending, 비동기 처리에 의해 원하는 올바른 결과를 얻어와 그 결과를 정상적으로 처리하고자 resolve가 호출된 Fulfilled 상태, 무언가 잘못되어 예외로 처리하고자 reject가 호출된 Rejected 상태입니다. 위의 짧은 코드를 살펴보면, 어떤 이 3가지 상태에 대한 시점을 확인할 수 있습니다. resolve와 reject는 각각 성공과 실패에 대한 결과값을 얻을 수 있는 객체를 전달할 수 있습니다. 위의 코드에서는 각각 1와 -1을 넘겨주고 있습니다. 주목할 점은 resolve와 reject는 동시에 같이 실행될 수 없으며 배타성을 갖습니다. 즉, resolve가 호출되면 reject 코드가 호출된다고 해도 실행되지 않으며, reject 코드가 호출되면 resolve가 호출되어도 reject가 호출되지 않습니다. 또 하나는 resolve에 의해 실행되는 callback은 resolve가 호출될때 즉시 실행되지 않습니다. 위의 코드의 주석을 보면 console.log(‘1’)과 consloe.log(‘2’)의 위치 사이에 각각 resolve와 reject가 있는데.. 실행순서는 console.log(‘1’)과 console.log(‘2)가 먼저 실행되고 resolve 또는 reject에 연결된 함수가 호출된다는 점입니다. 이 글의 마지막으로.. reject가 호출되면 예외를 던지게 됩니다. 위의 코드는 적당한 예외에 대한 처리를 하고 있지 않습니다. 이 예외 처리까지 포함된 코드는 다음과 같습니다.

function test() {
    return new Promise((resolve, reject) => {
        setTimeout(() => {
            let bOK = false;

            if(bOK) {
                resolve(1);           
            } else {
                reject(-1); // Promise의 catch로 넘겨준 함수를 호출해 줌
            }
        }, 2000);
    })
}

function callback(result) {
    console.log('Hello! : ' + result)
}

function callbackError(result) {
    console.log('Oh my god! : ' + result)
}

test().then(callback, callbackError).catch(callbackError); // then과 catch는 Promise 객체를 반환해줌
// test().then(callback, callbackError); // 바로 위의 코드와 동일함

reject 함수의 호출로 인해 Promise 객체의 catch로 넘겨준 함수를 호출할 수 있게 되어 적절한 예외 처리가 가능해 집니다.

Promise는 사실 기반 API입니다. 즉, Promise를 기반으로 상대적으로 상위 레벨의 API를 통해 Promise를 사용하게 되는데요. async/await나 fetch가 바로 그것인데요, fetch는 아래의 글을 참고하시기 바랍니다.
ES6의 Fetch API

matplotlib에서 애니메이션 그래프 표현하기

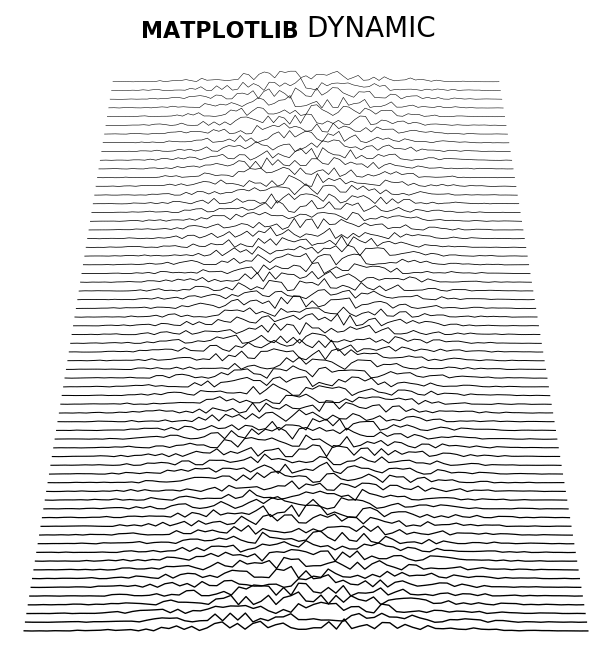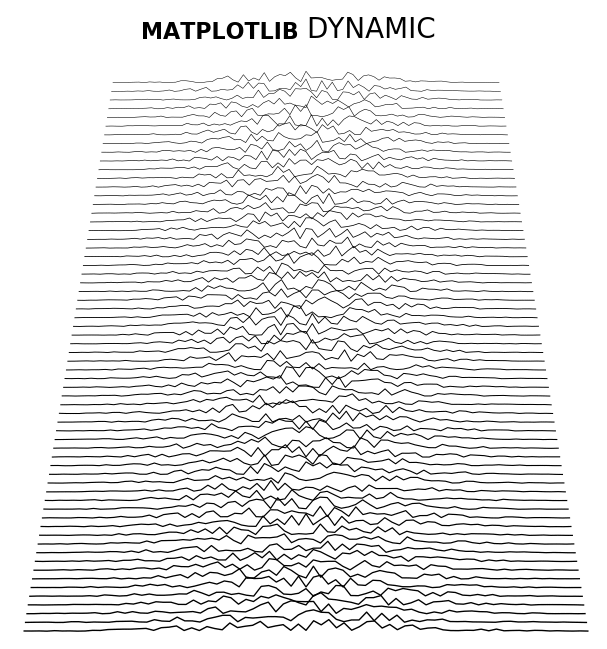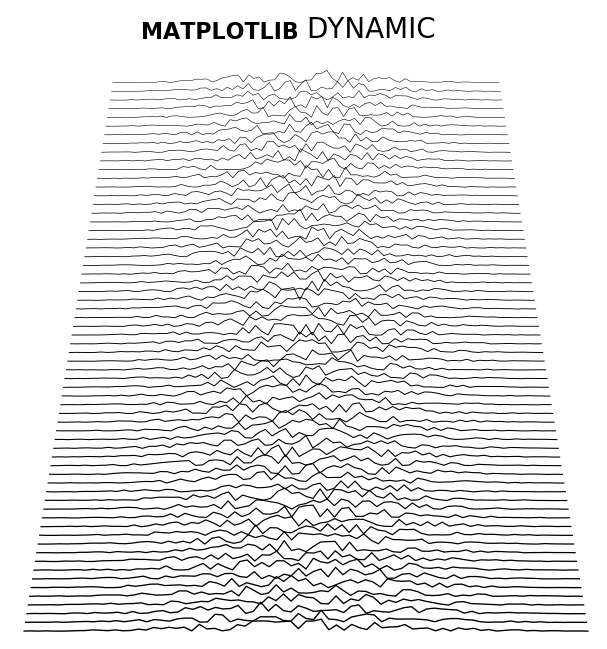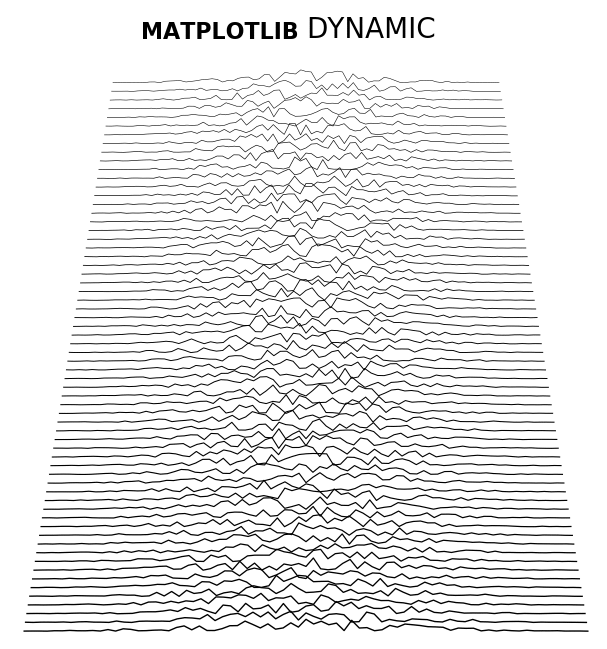
matplotlib는 다양한 그래프를 표현할 수 있는데요. 정적인 그래프 뿐만 아니라 데이터가 실시간으로 변경되면 그에 대한 동적인 그래프도 표현할 수 있습니다. 아래는 예시로써 그 결과입니다.

위의 예시를 실제로 구현하기 위한 코드를 살펴 보겠습니다. 이를 위해 먼저 그래프로 표현하기 위한 데이터가 필요한데, 아래의 코드는 데이터를 구성하는 코드입니다.

import numpy as np
import matplotlib.pyplot as plt
import matplotlib.animation as animation

data = np.random.uniform(0, 1, (64, 75))
X = np.linspace(-1, 1, data.shape[-1])
G = 1.5 * np.exp(-4 * X ** 2)

예시의 결과를 보면, 65개의 꺽은선 그래프로 구성되어 있습니다. 아래는 이 꺽은선 그래프를 구성하는 코드입니다.

import matplotlib.pyplot as plt

fig = plt.figure(figsize=(8, 8))
ax = plt.subplot(111, frameon=False)

lines = []
for i in range(data.shape[0]):
    xscale = 1 - i / 200.0
    lw = 1 - i / 100.0
    line, = ax.plot(xscale * X, i + G * data[i], color="k", lw=lw)
    lines.append(line)

이제 최종적으로 데이터를 0.2초마다 변경하고, 변경된 데이터에 대한 그래프를 업데이트하면서 마치 동적으로 그래프가 움직이는 효과를 내는 코드를 살펴 보겠습니다.

import matplotlib.animation as animation

ax.set_xticks([])
ax.set_yticks([])

ax.text(0.5, 1.0, "MATPLOTLIB ", transform=ax.transAxes, ha="right", va="bottom", color="k", 
        family="sans-serif", fontweight="bold", fontsize=16)
ax.text(0.5, 1.0, "DYNAMIC", transform=ax.transAxes, ha="left", va="bottom", color="k",
        family="sans-serif", fontweight="light", fontsize=20)

def update(*args):
    data[:, 1:] = data[:, :-1]
    data[:, 0] = np.random.uniform(0, 1, len(data))

    for i in range(len(data)):
        lines[i].set_ydata(i + G * data[i])

anim = animation.FuncAnimation(fig, update, interval=200)
plt.show()

단순 선형 회귀에 대한 2가지 접근

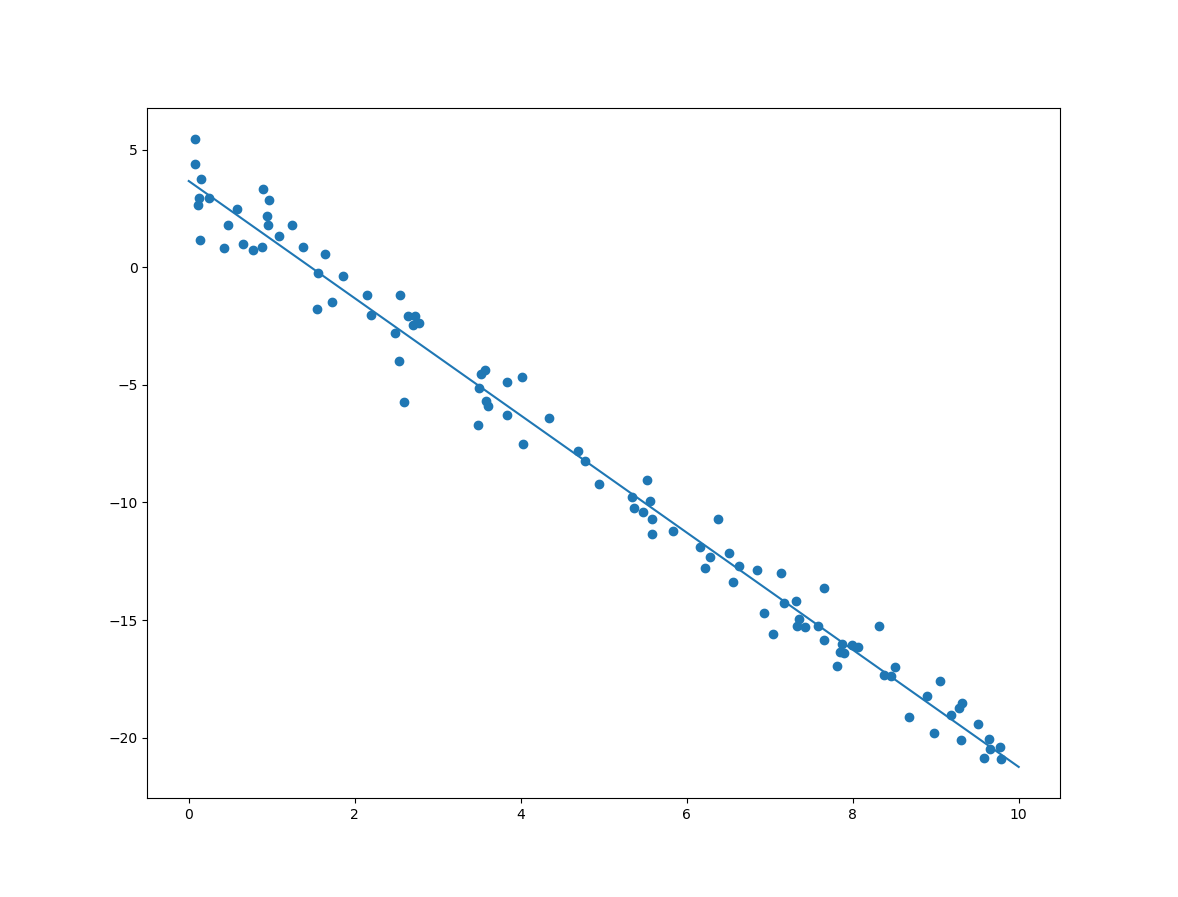
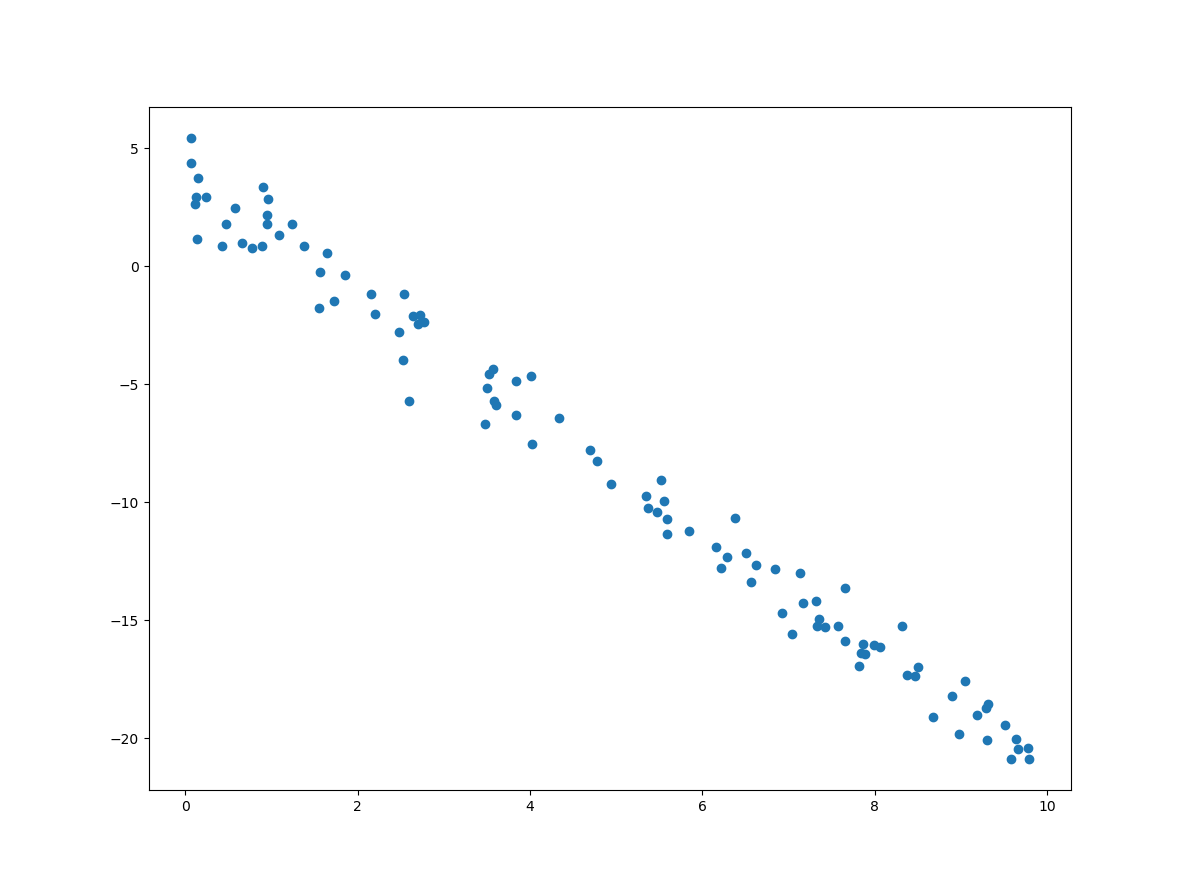
잡음이 섞인 샘플 데이터가 선형이라고 가정할때, 이 선형 모델은 기울기와 절편이라는 값으로 정의됩니다. 이 기울기와 절펀에 대한 값을 구하는 방법은 다양한데, 이 글에서는 2가지 접근 방법을 언급합니다. 먼저 잡음이 섞인 샘플 데이터는 다음과 같습니다.

import numpy as np
import matplotlib.pyplot as plt

X = 10 * np.random.rand(100,1)
y = 3.7 - 2.5 * X + np.random.randn(100,1)
plt.scatter(X, y)
plt.show()

위의 코드는 샘플 데이터에 대한 시각화 코드도 포함하고 있는데, 그 결과는 다음과 같습니다.

이제 위의 샘플 데이터에 대한 선형회귀 방법 중 하나인 정규방정식(Normal Equation)에 대한 코드는 다음과 같습니다.

X_b = np.c_[np.ones((100,1)), X]
w = np.linalg.inv(X_b.T.dot(X_b)).dot(X_b.T).dot(y)
print(w)

plt.scatter(X, y)
drawLine(w[1], w[0])
plt.show()

분석된 절편과 기울기에 대한 출력 및 결과 모델의 선형은 다음과 같습니다.

[[ 3.76686801]
 [-2.50677558]]

아울러 정규방정식은 다음과 같습니다.

    $$(X^{T}X)^{-1}X^{T}y$$

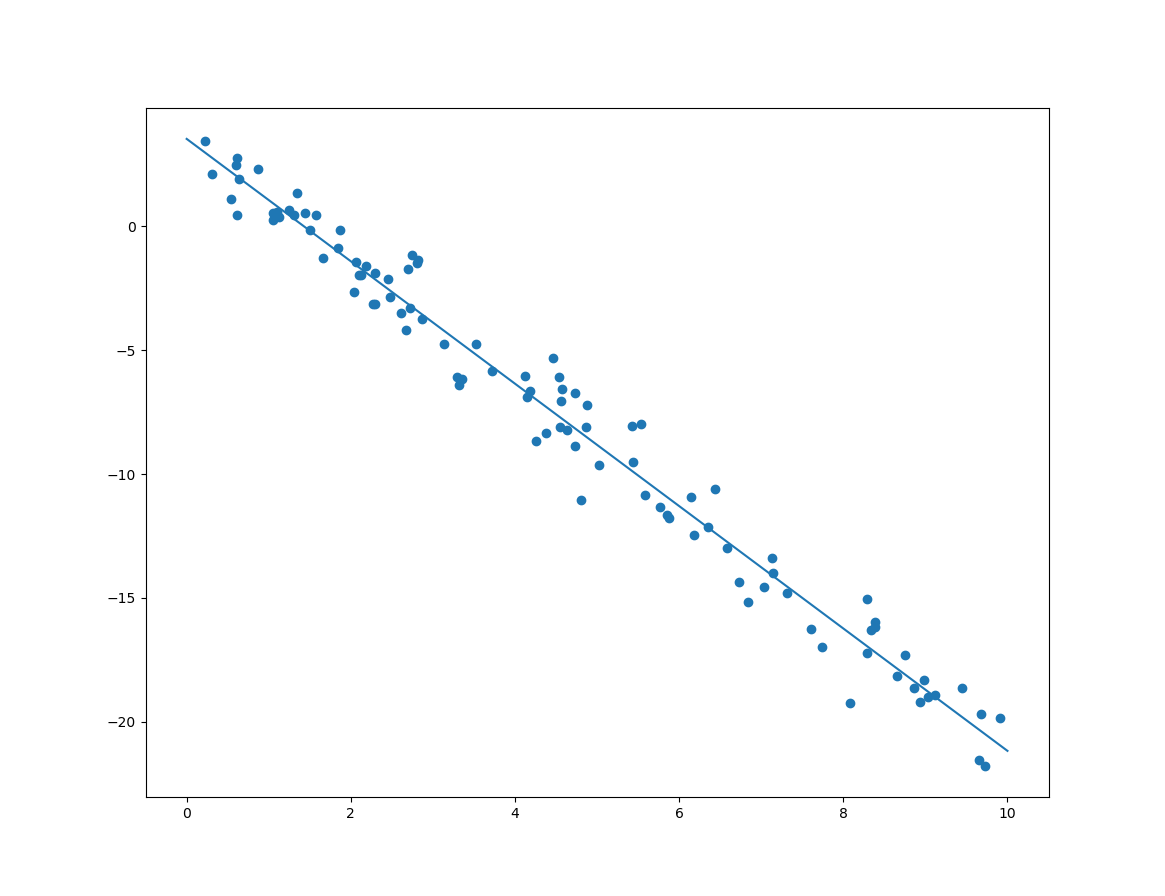
다음은 사이킷런에서 제공하는 LinearRegression 클래스를 이용한 방법입니다.

from sklearn.linear_model import LinearRegression
model = LinearRegression()
model.fit(X, y)
w = [model.intercept_[0], model.coef_[0][0]]
print(w)

plt.scatter(X, y)
drawLine(w[1], w[0])
plt.show()

분석된 절편과 기울기에 대한 출력 및 결과 모델의 선형은 다음과 같습니다.

[[ 3.69686801]
 [-2.50677558]]

위의 코드에서 절편과 기울기를 통해 그래프를 그리는 함수인 drawLine은 다음과 같습니다.

def drawLine(m, b):
    X = np.arange(0, 11)
    y = [m * x + b for x in X]
    plt.plot(X, y)

혼돈행렬(Confusion Matrix)와 정밀도, 재현률, F1점수

이 글은 한빛미디어의 핸즈온 머신러닝을 수업자료로써 파악하면서 이해한 바를 짧게 요약한 글입니다. 요즘 이 책을 통해 머신러닝을 다시 접하고 있는데, 체계적이고 좋은 내용을 제공하고 있고, 나 자신을 위한 보다 명확한 이해를 돕고자 이 글을 작성 작성합니다. 요즘 제가 블로그에 올리는 머신러닝 관련 글은 대부분 이 책의 내용에 대한 나름대로의 해석을 토대로 합니다. 보다 자세한 내용은 해당 도서를 참고하기 바랍니다.

이글은 훈련된 예측 모델을 평가하기 위한 지표인 정밀도, 재현률, F1에 대한 내용입니다. 이러한 평가 지표는 혼돈행렬이라는 데이터를 토대로 계산되는데요, 먼저 혼돈행렬을 구하기 위해 학습 데이터셋이 필요하며, 0~9까지의 숫자를 손으로 작성한 MINIST를 사용하고, 이 손글씨가 7인지에 대한 예측 모델을 예로 합니다. MNIST 데이터셋을 다운로드 받고, 레이블 데이터를 재가공합니다.

from sklearn.datasets import fetch_openml
import numpy as np

mnist = fetch_openml('mnist_784', version=1, data_home='D:/__Temp__/_')

X, y = mnist["data"], mnist["target"]
y = y.astype(np.uint8)

X_train, X_test, y_train, y_test = X[:60000], X[60000:], y[:60000], y[60000:]
y_train_7 = (y_train == 7)
y_test_7 = (y_test == 7)

예측 모델은 SGDClassifier를 사용합니다.

from sklearn.linear_model import SGDClassifier

model = SGDClassifier(random_state=3224)

혼돈 행렬을 얻기 위해 다음 코드를 실행합니다.

from sklearn.model_selection import cross_val_predict
from sklearn.metrics import confusion_matrix

y_train_pred = cross_val_predict(model, X_train, y_train_7, cv=3)
cf = confusion_matrix(y_train_7, y_train_pred)
print(cf)
[[53223   512]
 [  726  5539]]

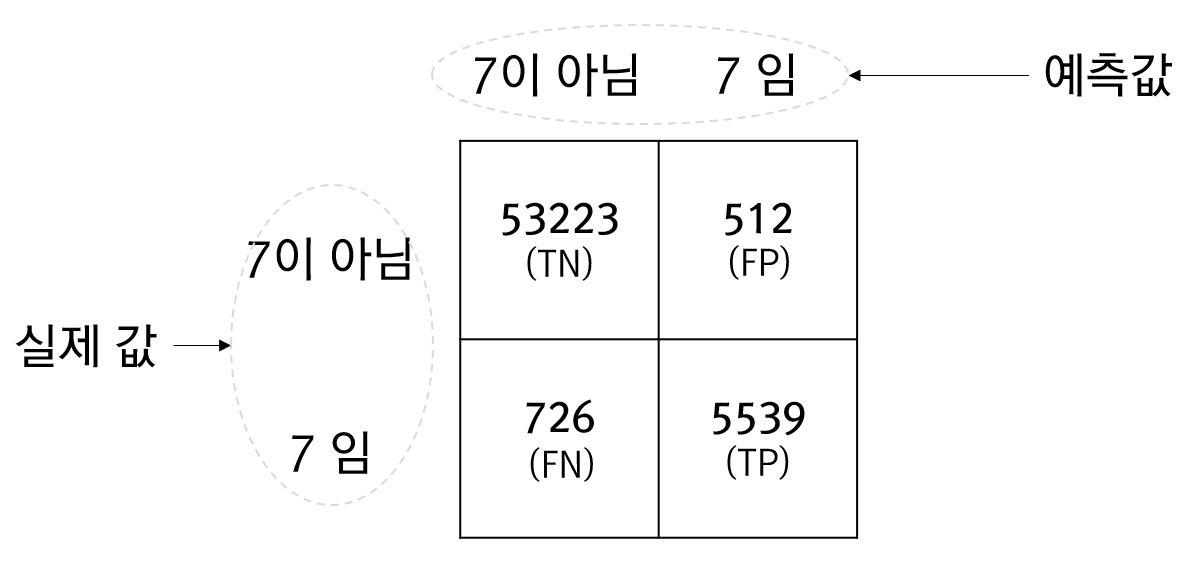
cross_val_predict 함수는 아직 전혀 학습이 되지 않은 모델을 지정된 교차검증 수만큼 학습시킨 뒤 예측값을 반환합니다. 이렇게 얻은 예측값과 실제 값을 비교해서 얻은 혼돈행렬의 결과에 대한 상세한 이미지는 아래와 같습니다.

위의 그림에서 표에 담긴 4개의 값은 발생횟수입니다. TN과 TP의 값은 옳바르게 예측한 횟수이고 FN과 FP는 잘못 예측한 횟수입니다. 즉, FN과 FP가 0일때 모델은 완벽하다는 의미입니다.

이제 위의 혼돈행렬에서 정밀도(Precision)와 재현률(Recall), F1점수에 대한 수식은 다음과 같습니다.

    $$Precision=\frac{TP}{TP+FP}, Recall=\frac{TP}{TP+FN},F1=2\times\frac{Precision \times Recall}{Precision+Recall}$$

정밀도와 재현률이 서로 상반관계에 있습니다. 즉, 정밀도가 높으면 재현률이 떨어지며 재현률이 높아지면 정밀도가 떨어지는 경향이 있습니다. F1은 이런 상반관계에 있는 정밀도와 재현률을 묶어 평가하고자 하는 지표입니다.

비록 정밀도와 재현률, F1점수는 매우 단순해 계산하기 쉬우나 다음의 코드를 통해서도 쉽게 얻을 수 있습니다.

from sklearn.metrics import precision_score, recall_score, f1_score
p = precision_score(y_train_7, y_train_pred)
print(p)
r = recall_score(y_train_7, y_train_pred)
print(r)
f1 = f1_score(y_train_7, y_train_pred)
print(f1)
0.9153858866303091
0.8841181165203511
0.8994803507632347

OneHot 인코딩(Encoding) 및 스케일링(Scaling)

학습 데이터의 특성들은 수치값 뿐만 아니라 ‘크다’, ‘중간’, ‘작다’ 또는 ‘여자’, ‘남자’와 같은 범주값도 존재합니다. 먼저 범주형 값을 처리하기 위해서는 이 범주형 값을 수치값으로 변환해야 합니다. 만약 범주형 값이 ‘A등급’, ‘B등급’, ‘C등급’처럼 그 의미에 순위적 연속성이 존재한다면 그냥 3, 2, 1과 같이 수치값으로 등급을 매칭하면 됩니다. 하지만 ‘여자’, ‘남자’처럼 순위도 연속성도 없다면 반드시 다른 의미로의 수치값으로 변환해야 하는데, 그 변환은 OnHot 인코딩이라고 합니다. 결론을 미리 말하면 ‘여자’라면 벡터 (1,0)으로, 남자라면 (0,1)으로 변경해야 합니다.

샘플 데이터를 통해 이 OneHot 인코딩을 하는 방법에 대해 언급하겠습니다. 샘플 데이터는 아래의 글에서 소개한 데이터를 사용합니다.

분석가 관점에서 데이터를 개략적으로 살펴보기

먼저 샘플 데이터를 불러옵니다.

import pandas as pd

raw_data = pd.read_csv('./datasets/datasets_1495_2672_abalone.data.csv', 
        names=['sex', 'tall', 'radius', 'height', 'weg1', 'weg2', 'weg3', 'weg4', 'ring_cnt'])
    #names=['성별', '키', '지름', '높이', '전체무게', '몸통무게', '내장무게', '껍질무게', '껍질의고리수']

이 중 sex 컬럼은 성별인데, 이 컬럼의 값을 아래의 코드를 통해 출력해 봅니다.

print(raw_data["sex"][:10])
0    M
1    M
2    F
3    M
4    I
5    I
6    F
7    F
8    M
9    F

범주형 값이라는 것을 알수있는데, M은 숫컷, F는 암컷, I는 유충입니다. 이 sex 컬럼에 대해 OneHot 인코딩 처리를 위해 먼저 문자형을 숫자형으로 변환해주는 OrdinalEncoder 클래스를 통해 처리합니다.

raw_data_labels = raw_data["ring_cnt"].copy()
raw_data = raw_data.drop("ring_cnt", axis=1)

raw_data_cat = raw_data[["sex"]]

from sklearn.preprocessing import OrdinalEncoder

ordinal_encoder = OrdinalEncoder()
raw_data_encoded = ordinal_encoder.fit_transform(raw_data_cat)

print(raw_data_encoded[:10])
print(ordinal_encoder.categories_)
[[2.]
 [2.]
 [0.]
 [2.]
 [1.]
 [1.]
 [0.]
 [0.]
 [2.]
 [0.]]
[array(['F', 'I', 'M'], dtype=object)]

OrdinalEncoder는 범주형 데이터를 희소행렬(Sparse Matrix)로 그 결과를 반환합니다. 다시 이 희소행렬을 OneHot 인코딩을 시키기 위해 아래의 코드를 수행합니다.

from sklearn.preprocessing import OneHotEncoder
onehot_encoder = OneHotEncoder()
raw_data_cat_onehot = onehot_encoder.fit_transform(raw_data_cat)
print(raw_data_cat_onehot.toarray()[:10])
print(onehot_encoder.categories_)
[[0. 0. 1.]
 [0. 0. 1.]
 [1. 0. 0.]
 [0. 0. 1.]
 [0. 1. 0.]
 [0. 1. 0.]
 [1. 0. 0.]
 [1. 0. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
[array(['F', 'I', 'M'], dtype=object)]

이제 범주형 컬럼인 sex 대신 OneHot 인코딩된 값을 데이터에 추가하도록 합니다.

raw_data = raw_data.drop("sex", axis=1)
raw_data = np.c_[raw_data_cat_onehot.toarray(), raw_data]
print(raw_data[:10])
[[0.0 0.0 1.0 0.455 0.365  0.095 0.514  0.2245 0.100999 0.15  4]
 [0.0 0.0 1.0 0.35  0.265  0.09  0.2255 0.0995 0.0485   0.07  2]
 [1.0 0.0 0.0 0.53  0.42   0.135 0.677  0.2565 0.1415   0.21  4]
 [0.0 0.0 1.0 0.44  0.365  0.125 0.516  0.2155 0.114    0.155 4]
 [0.0 1.0 0.0 0.33  0.255  0.08  0.205  0.0895 0.0395   0.055 2]
 [0.0 1.0 0.0 0.425 0.3    0.095 0.3515 0.141  0.0775   0.12  3]
 [1.0 0.0 0.0 0.53  0.415  0.15  0.7775 0.237  0.1415   0.33  4]
 [1.0 0.0 0.0 0.545 0.425  0.125 0.768  0.294  0.1495   0.26  4]
 [0.0 0.0 1.0 0.475 0.37   0.125 0.5095 0.2165 0.1125   0.165 4]
 [1.0 0.0 0.0 0.55  0.44   0.15  0.8945 0.3145 0.151    0.32  4]]

범주형 타입인 sex가 제거되고 이 sex에 대한 추가적인 3개의 컬럼이 추가되었습니다. 바로 이 3개의 컬럼이 OneHot 인코딩된 값입니다.

이제 수치형 데이터에 대한 스케일링입니다. 여기서 스케일링이란 서로 다른 특성들을 일정한 값의 범위로 맞춰주는 것입니다. 흔히 사용하는 방식은 Min-Max 스케일링과 표준화(Standardization)이 있습니다. 먼저 Min-Max 스케일링은 특징의 최소값과 최대값을 먼저 계산하고 이 값을 이용하여 전체 특징값들을 0~1 사이의 값으로 변경시킵니다. 표준화는 먼저 평균과 표준편차를 구하고 전체 데이터 각각에 대해 평균을 뺀 후 표준편차로 나눠 분산이 1이 되도록 데이터를 조정합니다. 각각 sklearn에서 제공하는 MinMaxScaler와 StandardScaler 클래스를 통해 수행이 가능합니다. 아래의 코드는 Min-Max 스케일링을 수행하는 코드입니다.

from sklearn.preprocessing import MinMaxScaler

minmax_scaler = MinMaxScaler()
raw_data = minmax_scaler.fit_transform(raw_data)

print(raw_data[:10])
[[0. 0.  1.   0.51351351 0.5210084  0.0840708   0.18133522 0.15030262 0.1323239  0.14798206 0.75 ]
 [0. 0.  1.   0.37162162 0.35294118 0.07964602  0.07915707 0.06624075 0.06319947 0.06826109 0.25 ]
 [1. 0.  0.   0.61486486 0.61344538 0.11946903  0.23906499 0.17182246 0.18564845 0.2077728  0.75 ]
 [0. 0.  1.   0.49324324 0.5210084  0.11061947  0.18204356 0.14425017 0.14944042 0.15296462 0.75 ]
 [0. 1.  0.   0.34459459 0.33613445 0.07079646  0.07189658 0.0595158  0.05134957 0.0533134  0.25 ]
 [0. 1.  0.   0.47297297 0.41176471 0.0840708   0.12378254 0.09414929 0.10138249 0.1180867  0.5  ]
 [1. 0.  0.   0.61486486 0.60504202 0.13274336  0.27465911 0.15870881 0.18564845 0.32735426 0.75 ]
 [1. 0.  0.   0.63513514 0.62184874 0.11061947  0.27129449 0.19704102 0.1961817  0.25759841 0.75 ]
 [0. 0.  1.   0.54054054 0.52941176 0.11061947  0.17974146 0.14492266 0.14746544 0.16292975 0.75 ]
 [1. 0.  0.   0.64189189 0.64705882 0.13274336  0.31609704 0.21082717 0.19815668 0.31738914 0.75 ]]

결과를 보면 전체 데이터가 모두 0~1 사이의 값으로 변환된 것을 알 수 있습니다.