[C++] Stream을 이용한 Typed Binary 데이터 읽고 쓰기

C++은 stream을 통해 반복자(iterator)를 이용해 데이터를  매우 유연하게 처리 할 수 있습니다. 이 스트림을 통해 데이터의 입력을 키보드나 파일 등을 통해 매우 유연하고 효과적으로 읽고 쓸 수 있는데요. 문제는 일반화된 문자열에 대한 읽고 쓰기에 중심을 두고 있다는 점입니다.  즉,  C++의 스트림을 이용해 실수 타입의 값으로 3.14159265라는 값을 파일에 저장하고자 한다면, 이 값을 메모리에 저장된 그대로의 실수형 바이너리 형식으로의 저장이 아닌 “3.14159265”라는 문자열로 저장되는 것이 C++ 개발자에게 흔히 노출된 방식이라는 것입니다.

다 이유가 있겠으나, 필자는 이 실수형 값을 메모리에 저장된 그대로의 실수형 바이너리 형식으로 파일에 저장하고, 이렇게 저장된 값을 다시 파일을 열어 꺼내와 화면에 표시하고자 합니다.

먼저 3.14159265 값을 d 드라이브의 data.bin에 저장하는 코드입니다.

#include <iostream>
#include <fstream>

int main()
{
	std::ofstream os("d:\\data.bin", std::ios::binary);

	double v = 3.141592625;
	os.write(reinterpret_cast<const char*>(&v), sizeof(double));

	os.close();
}

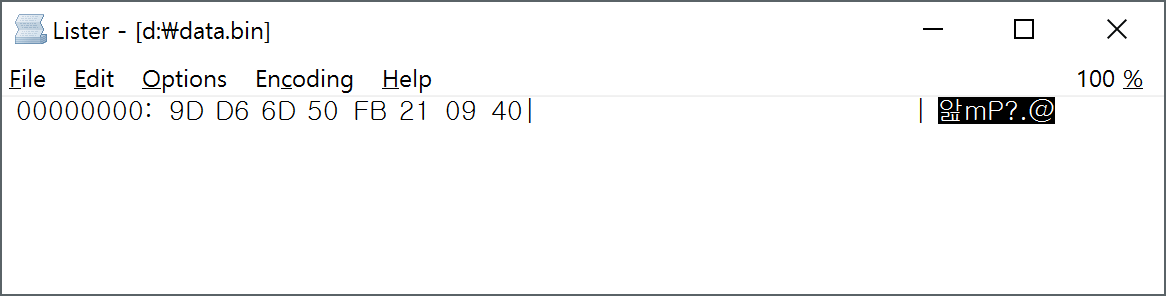
실행해 보면 data.bin 파일이 생성되어졌고, 파일 크기는 double의 바이트 크기와 동일한 8바이트인 것을 확인할 수 있습니다.
이제 이렇게 생성된 파일에서 다시 실수형 값을 읽어 보는 코드는 다음과 같습니다.

#include <iostream>
#include <fstream>

int main()
{
	std::ifstream is("d:\\data.bin", std::ios::binary);

	double v2;
	is.read(reinterpret_cast<char*>(&v2), sizeof(double));
	
	is.close();

	std::cout << v2;
}

여기서 C++의 template을 이용해 개선을 해보도록 하겠습니다. 즉, 다음과 같은 2개의 템플릿 함수를 추가합니다.

template<typename T>
std::ostream& write_typed_data(std::ostream& stream, const T& value) {
	return stream.write(reinterpret_cast<const char*>(&value), sizeof(T));
}

template<typename T>
std::istream & read_typed_data(std::istream& stream, T& value) {
	return stream.read(reinterpret_cast<char*>(&value), sizeof(T));
}

네, write_typed_data와 read_typed_data는 각각 임이의 데이터 타입에 대해서 지정된 스트림에 메모리에 저장된 그대로의 구조인 바이너리 형식으로 쓰고 읽는 범용 함수입니다.

이 두 함수를 활용해 3.141592625 값을 쓰고 읽는 전체 코드를 다시 작성해 보면 다음과 같습니다.

#include <iostream>
#include <fstream>

template<typename T>
std::ostream& write_typed_data(std::ostream& stream, const T& value) {
	return stream.write(reinterpret_cast<const char*>(&value), sizeof(T));
}

template<typename T>
std::istream & read_typed_data(std::istream& stream, T& value) {
	return stream.read(reinterpret_cast<char*>(&value), sizeof(T));
}

int main()
{
	// Write 
	std::ofstream os("d:\\data.bin", std::ios::binary);

	double v = 3.141592625;
	//os.write(reinterpret_cast<const char*>(&v), sizeof(double));
	write_typed_data(os, v);

	os.close();
	// <- test unit end

	// Read
	std::ifstream is("d:\\data.bin", std::ios::binary);

	double v2;
	read_typed_data(is, v2);
	//is.read(reinterpret_cast<char*>(&v2), sizeof(double));
	
	is.close();

	std::cout << v2;
	// <- test unit end
}

C++에서 스트림을 활용해 타입을 가지는 변수를 바이너리 형식으로 저장하는 위의 방식이 정석인지는 모르겠습니다. (이제와서 이게 무슨 소리? -_-;) reinterpret_cast를 사용했다는 점에서 상당히 의구심이 들기 때문인데요. 더욱 나은 방식이 있다면 제안해 주시기 바랍니다. reinterpret_cast는 포인터가 다른 포인터 형식으로 변환될 수 있도록 하거나 정수 계열 형식이 포인터 형식으로 변환될 수 있도록 하고 그 반대로도 변환될 수 있도록 하는 cast 연산자입니다.

Javascript로 URL의 QueryString을 파싱하고 값 얻기

만약 웹브라우저에서 입력한 url이 다음과 같다고 가정하면..

http://localhost/map.html?x=925641&y=1666020&level=10

위의 url에서 QueryString으로 지정된 파라메터를 다음과 같은 JavaScript 코드로 얻을 수 있다고 합시다.

var qs = getQueryStringObject();
var x = qs.x; // 925641
var y = qs.y; // 1666020
var l = qs.level; // 10

이때 getQueryStringObject 함수는 다음과 같습니다.

function getQueryStringObject() {
    var a = window.location.search.substr(1).split('&');
    if (a == "") return {};
    var b = {};
    for (var i = 0; i < a.length; ++i) {
        var p = a[i].split('=', 2);
        if (p.length == 1)
            b[p[0]] = "";
        else
            b[p[0]] = decodeURIComponent(p[1].replace(/\+/g, " "));
    }
    return b;
}

PostgreSQL에서 UUID Type 데이터 쿼리 및 업데이트

ID에 대한 고유한 값으로써 사용할만한 Type으로 PostgreSQL에서는 UUID 타입을 제공하는데요. 이 데이터 타입으로 조회하거나 Update하는 예는 아래와 같습니다.

select * from ecl_logic_node_p where networkid::text = '176f54c1-f333-426f-b4d5-29c365ec3ac3'
select * from ecl_logic_node_p where networkid = '176f54c1-f333-426f-b4d5-29c365ec3ac3'
select * from ecl_logic_node_p where networkid = '176f54c1-f333-426f-b4d5-29c365ec3ac3'::uuid

select networkid::text from ecl_logic_node_p

update ecl_logic_node_p set networkid = '176f54c1-f333-426f-b4d5-29c365ec3acf' where fid = 0

FingerEyes-Xr for HTML5 – ShapeMapLayer의 도형정보 및 속성 정보 접근

FingerEyes-Xr for HTML5의 레이어 중 ShapeMapLayer에 대해, 도형 정보 및 속성 정보에 접근하는 코드를 정리해 봅니다. 참고로 아래 코드는 Point 타입의 ShapeMapLayer에 대한 코드입니다.

var snodeLayerId = snode.layerId(); // Layer Id
var snodeNetworkId = snode.nodeId(); // 검색할 필드값
var snodeLayer = g_map.layers(snodeLayerId);
var snodeRowset = snodeLayer.shapeRowSet();
var snodeAttrRowset = snodeLayer.attributeRowSet();
var snodeFieldSet = snodeLayer.fieldSet();
var snodeRows = snodeRowset.rows();
var idxNetwordId = snodeFieldSet.fieldIndex('networkid'); // 검색 대상 필드명

for (var fid in snodeRows) {
    var attRow = snodeAttrRowset.row(fid);
    var vNetworkId = attRow.valueAsString(idxNetwordId);

    if (vNetworkId == snodeNetworkId) {
        var psRow = snodeRows[fid];
        var psData = psRow.shapeData();
        var pt = psData.data();

        alert(pt.x + " " + pt.y);

        break;
    }                    
}

Java8, Stream에 대한 병렬처리

Java 8에서 제공하는 스트림(Streams)에 대한 기능에 대해 정리한 적이 있습니다. Java 8에서 스트림은 List 등과 같은 자료구조를 통해 생성할 수 있는 메모리 상의 또 다른 자료구조인데요. 이 스트림 자료구조를 통해 Filter, Sorted, map, forEach, anyMatch, allMatch, noneMatch, count, Reduce 맴버 함수를 호출할 수 있으며, 이러한 함수 호출에 대해 하나의 스레드만을 사용해 처리할 것인지, 아니면 멀티 스레드를 통해 병렬로 처리할 것인지 개발자가 매우 간단히 정할 수 있는 매커니즘을 제공합니다.

예를 들어서, 백만개의 UUID 문자열을 담고 있는 리스트가 있다고 합시다. 즉, 아래의 코드를 통해 메모리 상에 구성될 수 있습니다.

public static void main(String args[]) {
    int max = 1000000;
    List values = new ArrayList<>(max);
		
    for (int i=0; i

11번과 12번 코드가 각각 백만개의 문자열를 갖는 리스트를 정렬하는 방식을 하나의 스레드로 할 것인지, 멀티 스레드로 처리할 것인에 대한 함수 호출입니다. 먼저 sequential 함수를 살펴보면 아래와 같습니다.

public static void sequential(List v) {
    long t0 = System.nanoTime();
    /*long count = */ v.stream().sorted().count();
    long t1 = System.nanoTime();
		
    long millis = TimeUnit.NANOSECONDS.toMillis(t1 - t0);
    System.out.println(String.format("sequential sort took: %d ms", millis));
}

3번 코드가 스트림에서 제공하는 sorted 함수를 통해 직관적으로 정렬하는 것으로써 코드 한줄이지만 그 내부는 다소 복잡하고, 특히나 백만개에 대한 정렬이므로 상당한 CPU 리소스를 사용할 것입니다. 그리고 다음은 멀티 스레드를 통한 parallel 함수입니다.

public static void parallel(List v) {
    long t0 = System.nanoTime();
    /* long count = */ v.parallelStream().sorted().count();
    long t1 = System.nanoTime();
		
    long millis = TimeUnit.NANOSECONDS.toMillis(t1 - t0);
    System.out.println(String.format("parallel sort took: %d ms", millis));
}

sequential 함수와의 차이점이라고는 오직 스트림을 생성하기 위해 3번 코드의 stream() 대신 parallelStream() 호출입니다. 이제 실행해 보면 제 노트북에서는 다음과 같은 결과가 나옵니다.

sequential sort took: 708 ms
parallel sort took: 244 ms

제 노트북이 멀티 코어 CPU이므로 동일한 연산이지만 병렬로 정렬하는데 소요되는 시간이 훨씬 더 빠른 처리된 결과를 볼 수 있습니다. Java 8에서 제공하는 스트림을 통해 데이터의 덩어리를 매우 직관적이며 매우 쉽게 병렬로 처리할 수 있다는 것을 알 수 있습니다.

요즘 golang과 같은 최신의 언어에서도 그렇고... Java나 C++과 같은 언어에서 람다 지원을 통해 작성된 코드를 살펴봐도 그렇고.. OOP 보다는 함수 지향적인 코딩이 상당히 강조되는 것을 느낍니다. OOP 적인 사고방식 보다는 컴포지션(Composition)과 재귀적 호출을 통한 함수 작성 그리고 짧은 코드로 구성한 단위 함수들의 조합을 통한 프로그래밍 방식에 익숙해 지는 것이 필요할 듯 합니다.